Data-analyse is het verzamelen, ordenen en interpreteren van gegevens om een vraag te beantwoorden: hoe groot is het probleem, en wat veroorzaakt het? In Lean Six Sigma is het de manier om van een vermoeden naar bewijs te komen, en te voorkomen dat je de verkeerde oorzaak aanpakt.
Een klassiek voorbeeld: John Snow en de cholera
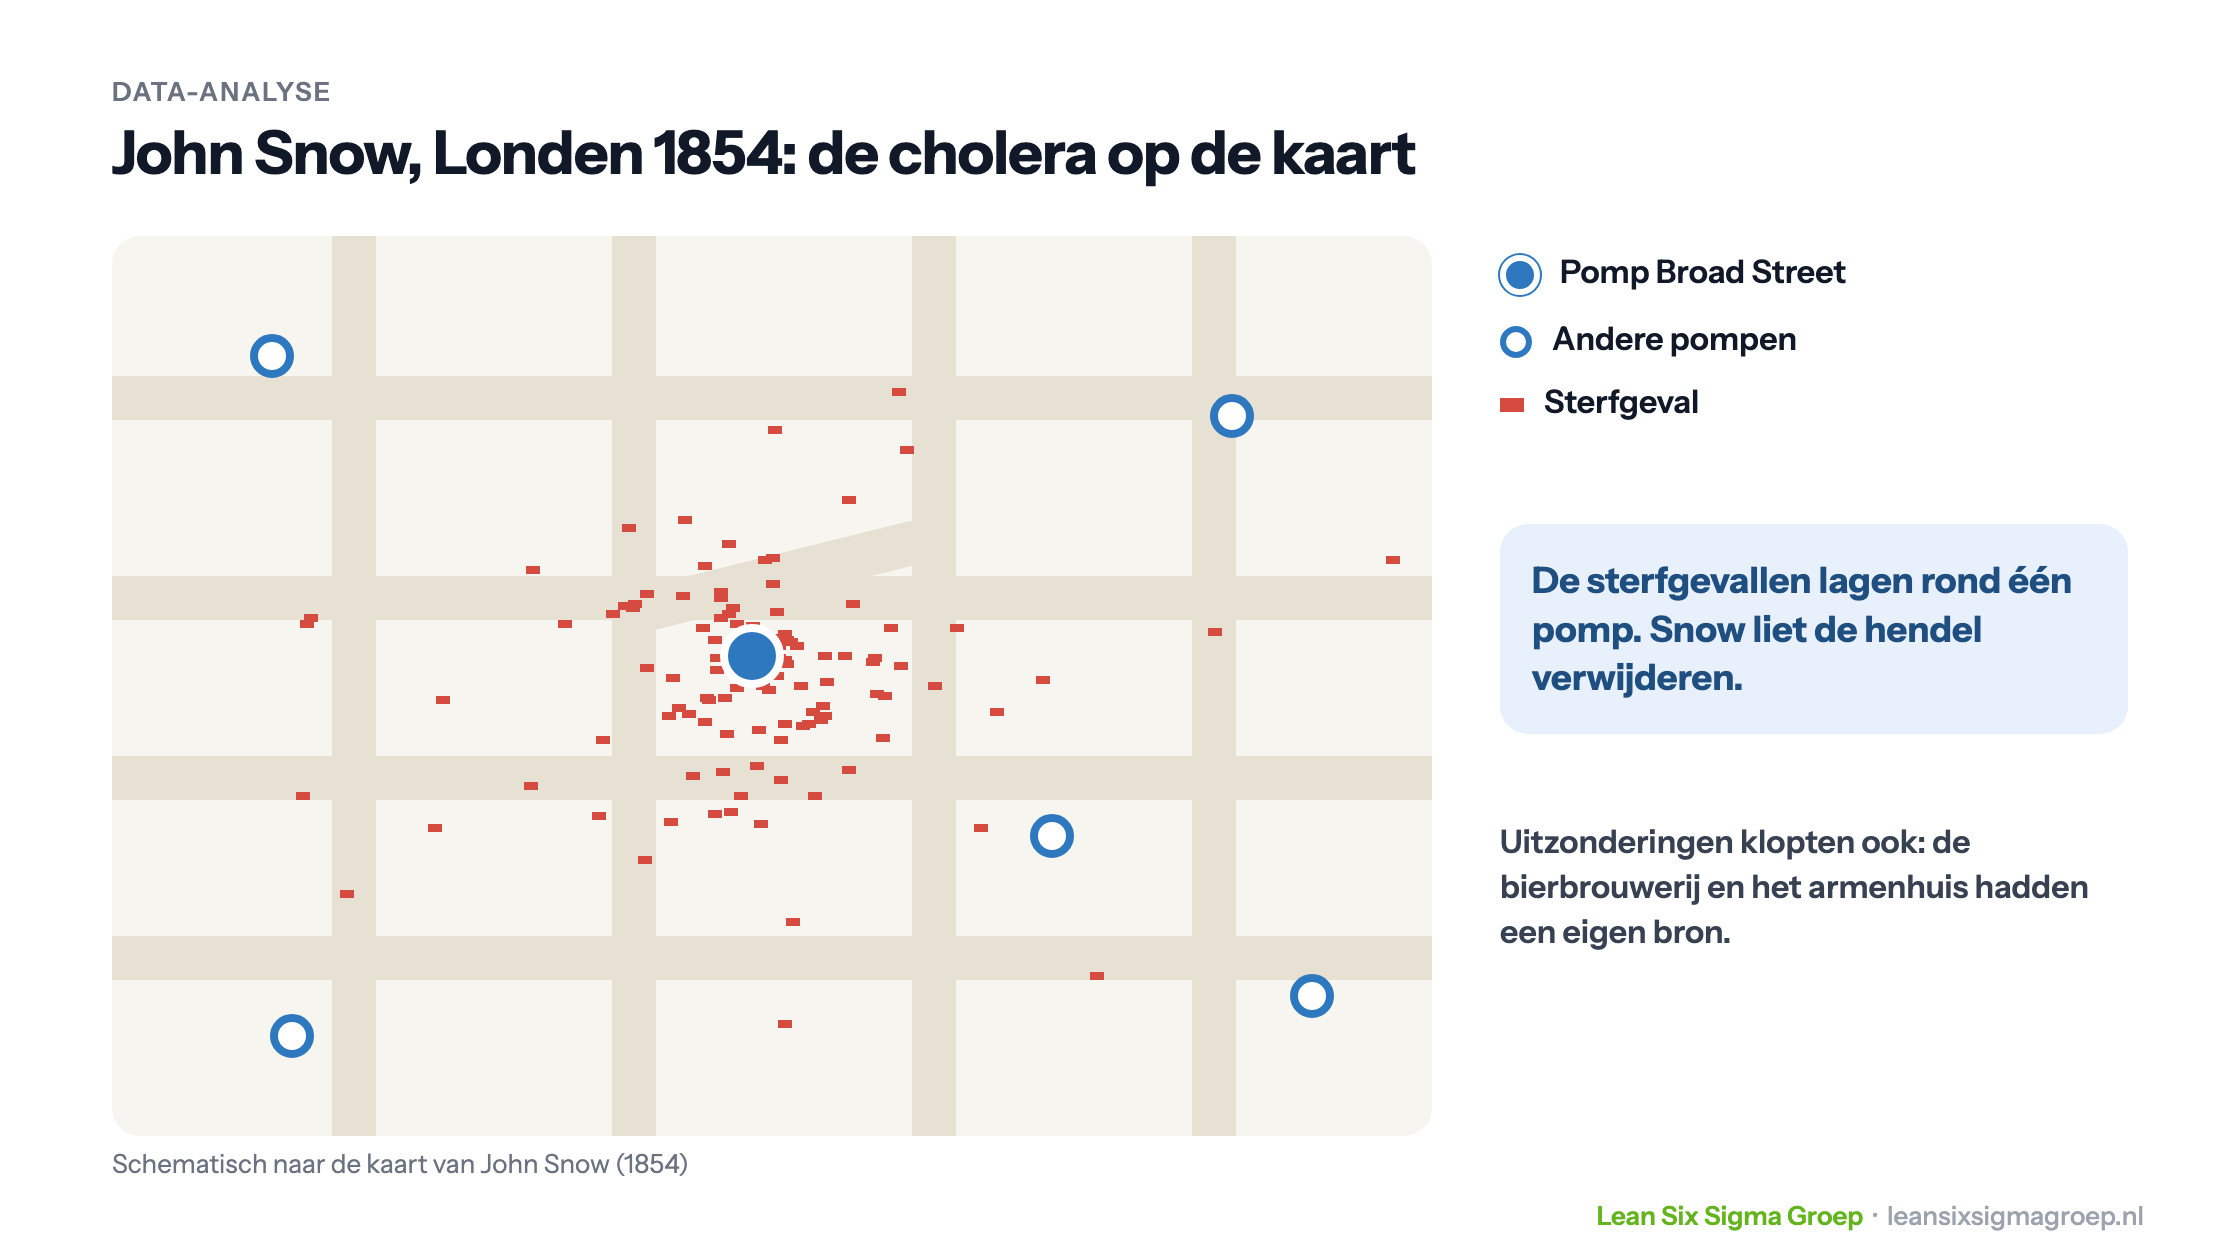
In de zomer van 1854 brak in de Londense wijk Soho een cholera-epidemie uit. In tien dagen stierven honderden mensen. De gangbare verklaring was “miasma”: ziekte zou zich verspreiden via vieze lucht. De arts John Snow twijfelde daaraan, en deed iets wat toen nog ongewoon was: hij zette alle sterfgevallen op een plattegrond van de wijk.
Het patroon was onmiskenbaar, zoals je in de afbeelding bovenaan dit artikel ziet. De sterfgevallen lagen rond één waterpomp, in Broad Street. Snow keek ook naar de uitzonderingen. In de bierbrouwerij vlak bij de pomp werd bijna niemand ziek: de arbeiders dronken bier, en de brouwerij had een eigen bron. Ook het armenhuis in de buurt, met een eigen put, bleef grotendeels gespaard. En een paar slachtoffers die verder weg woonden, bleken juist water uit Broad Street te halen.
Snow overtuigde het bestuur om de hendel van de pomp te halen. De epidemie was toen al over haar hoogtepunt, maar zijn analyse werd een mijlpaal: later bleek dat de put vervuild was door een beerput vlak ernaast. Snow geldt sindsdien als een van de grondleggers van de epidemiologie.
Wat het voorbeeld laat zien: niet de vergaderingen vol meningen vonden de oorzaak, maar de data, slim in beeld gebracht. En het loont om naar de uitzonderingen te kijken: waar gaat het wél goed, en wat is daar anders?
Data-analyse in Lean Six Sigma
In een Lean Six Sigma-project volgt data-analyse de stappen van DMAIC. Het doel laat zich samenvatten in één formule: Y = f(X). De Y is het probleem, de uitkomst die je wilt verbeteren. De X’en zijn de mogelijke oorzaken. De vraag is welke X’en de Y echt bepalen.
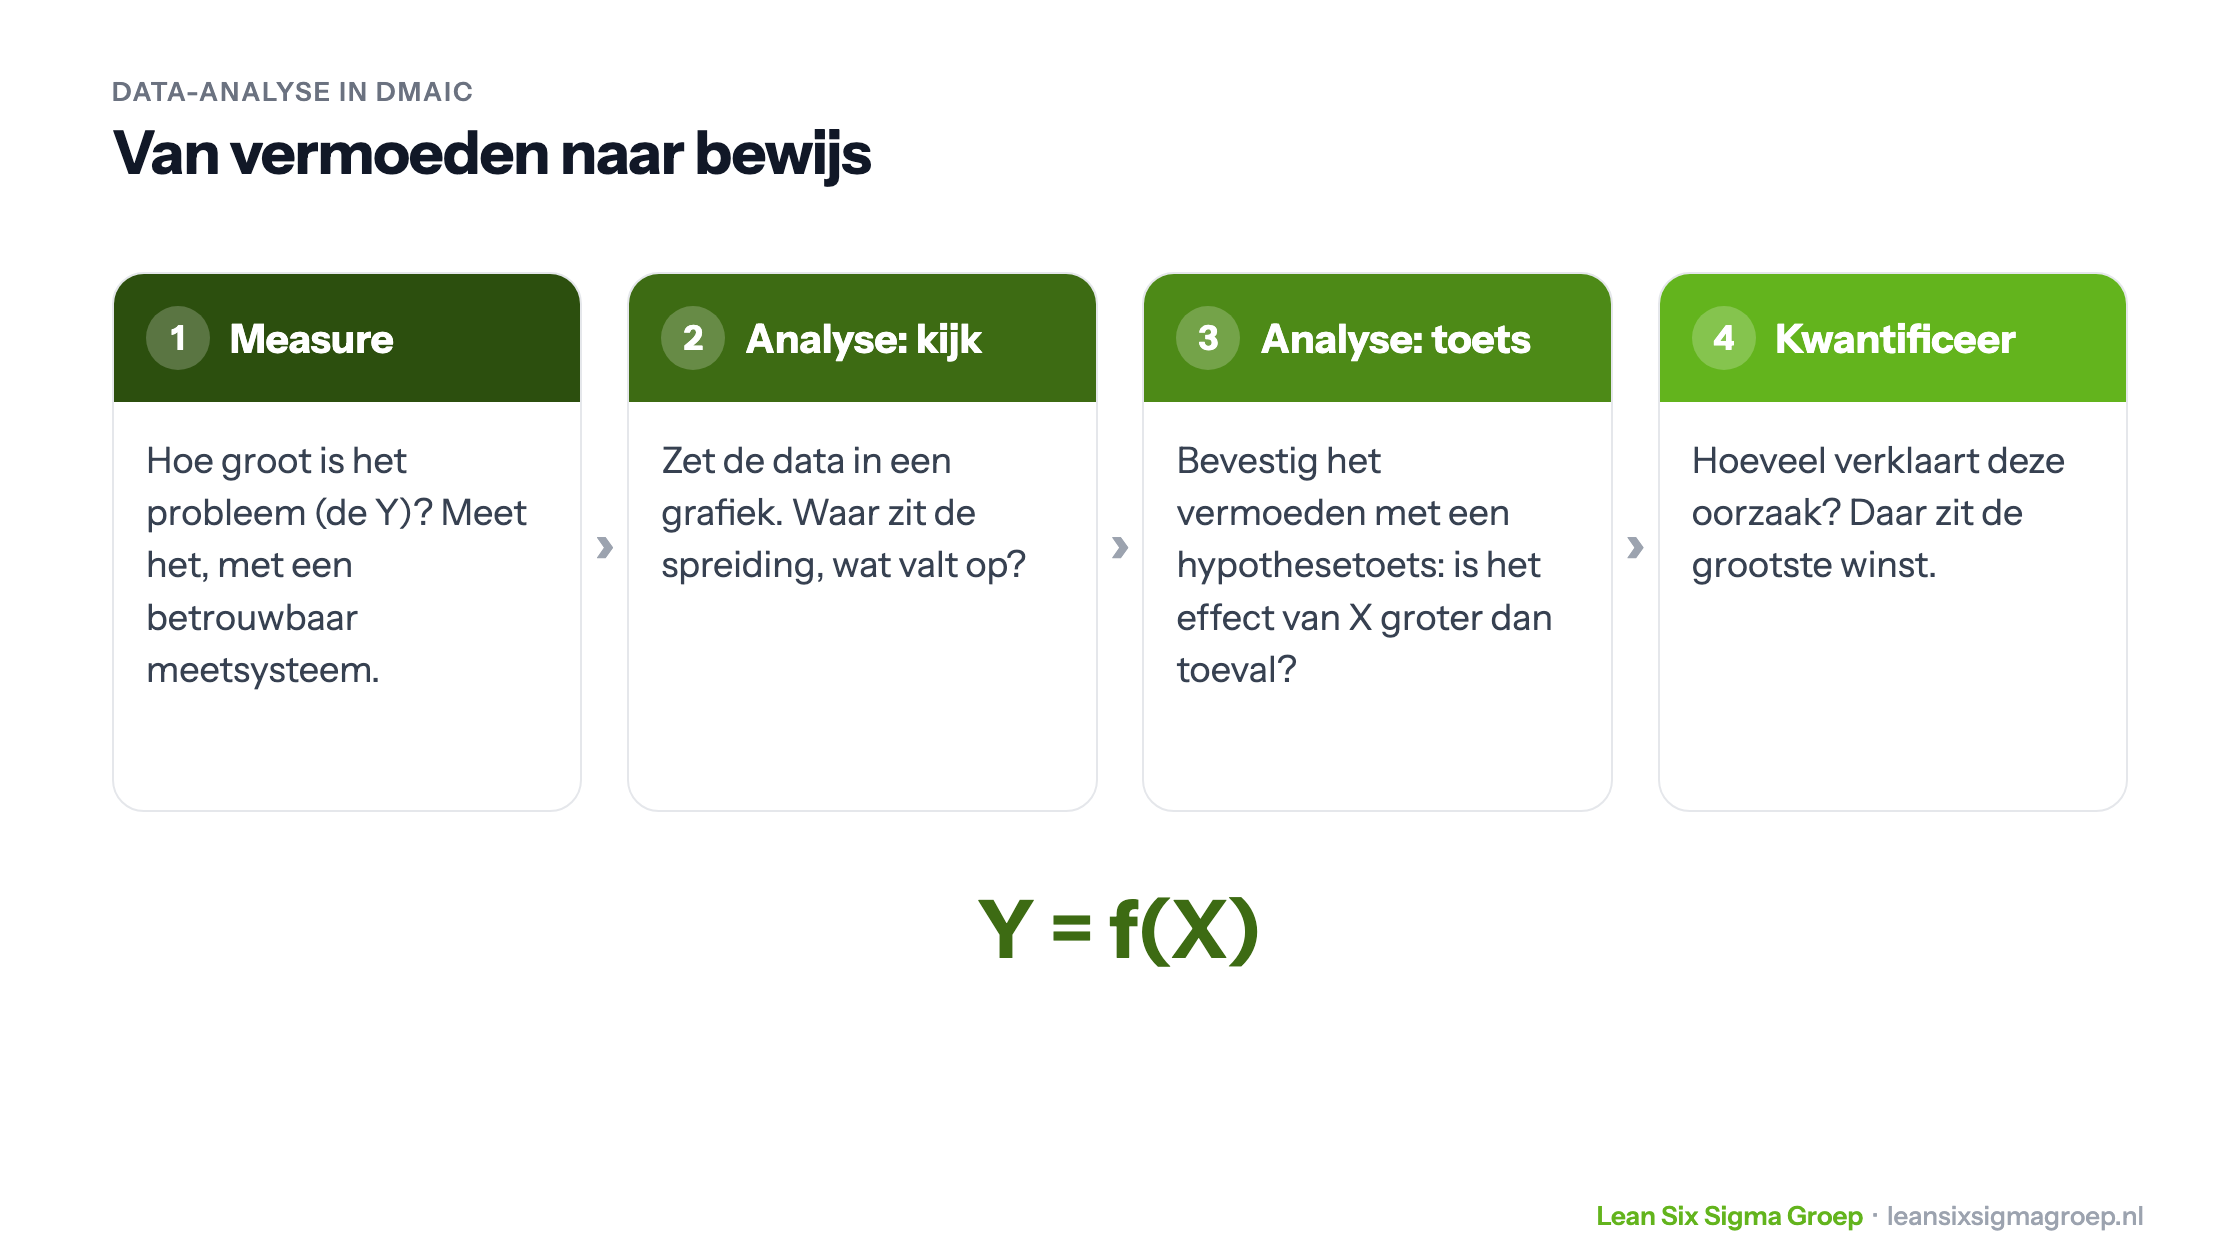
- Measure: hoe groot is het probleem? Je meet hoe het proces nu presteert, met een nulmeting. Eerst controleer je of je meetsysteem betrouwbaar is; anders analyseer je ruis.
- Analyse: kijk eerst. Zet de data in een grafiek, zoals een histogram, een boxplot of een spreidingsdiagram. Waar zit de spreiding, wat valt op, waar gaat het goed?
- Analyse: toets. Heb je een vermoeden, bevestig het dan met een hypothesetoets. Je gaat uit van de nulhypothese dat er geen verschil of verband is, en berekent hoe waarschijnlijk je data zijn als dat klopt. Is die kans (de p-waarde) heel klein, dan verwerp je de nulhypothese. Let op: de p-waarde is niet de kans dat de nulhypothese waar is.
- Kwantificeer. Hoeveel van de spreiding in Y verklaart deze X? Zo weet je welke oorzaak de meeste winst oplevert.
Daarbij helpt het om te weten met wat voor data je werkt; lees meer over continue en discrete data. En een verband is nog geen oorzaak: lees daarover bij correlatie.
Wat voegt data-analyse toe?
Een medewerker die al twintig jaar hetzelfde werk doet, kan vaak goed inschatten hoe een proces presteert. En er zijn ook andere manieren om oorzaken te vinden, zoals een visgraatdiagram of een value stream map. Data-analyse voegt daar twee dingen aan toe. Het stelt objectief vast hoe het proces presteert, ook als de ervaring iets anders zegt. En het laat zien hoe belangrijk een oorzaak is, met een getal in plaats van een gevoel.
Data-analyse toetst vooral een vermoeden. Wil je in grote hoeveelheden gegevens zoeken naar patronen die je nog niet kende, dan heet dat datamining.
In de Green Belt– en Black Belt-opleiding leer je data-analyse niet alleen begrijpen, maar ook zelf doen, onder meer met Minitab.