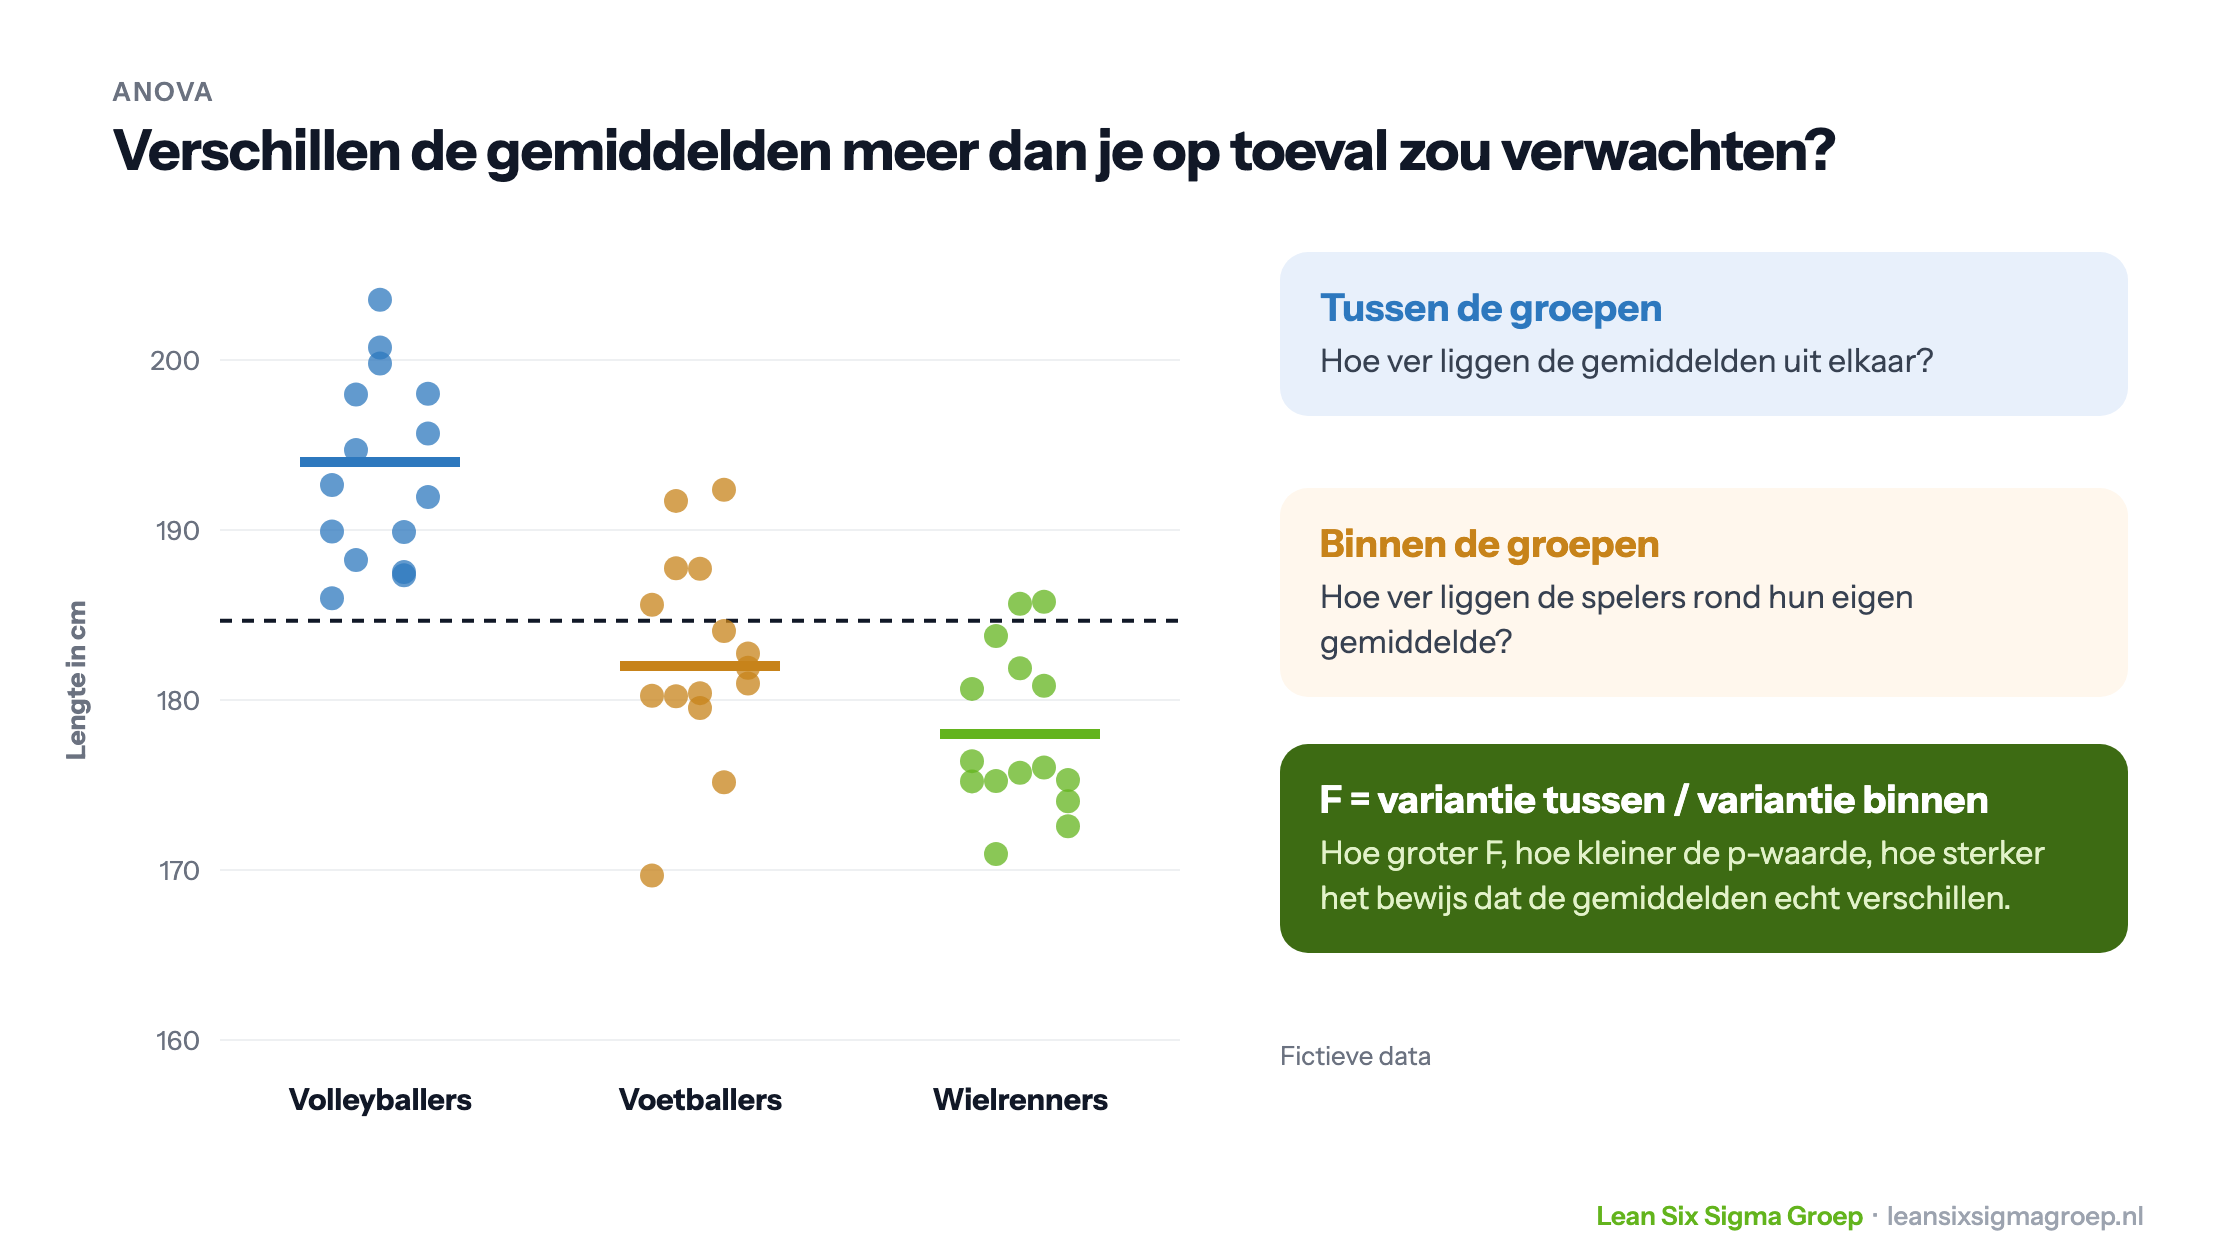
ANOVA staat voor analysis of variance, in het Nederlands variantieanalyse. Het is een hypothesetoets die nagaat of de gemiddelden van drie of meer groepen echt van elkaar verschillen, of dat de verschillen ook door toeval kunnen komen. Bijvoorbeeld: verschilt de gemiddelde doorlooptijd tussen drie teams, of is het verschil te klein om iets over te zeggen?
Hoe werkt ANOVA?
De naam is misleidend: ANOVA vergelijkt gemiddelden, maar doet dat via de spreiding. De toets deelt de totale variatie in de data op in twee delen, zoals je in de afbeelding bovenaan dit artikel ziet:
- Variatie tussen de groepen: hoe ver liggen de groepsgemiddelden uit elkaar?
- Variatie binnen de groepen: hoe ver liggen de waarnemingen rond hun eigen groepsgemiddelde?
De verhouding tussen die twee heet F. Is de variatie tussen de groepen veel groter dan de variatie binnen de groepen, dan is F groot, en is het onwaarschijnlijk dat de verschillen op toeval berusten. De toets geeft dat weer als een p-waarde.
De p-waarde lezen
- p kleiner dan 0,05: minstens één groep heeft een ander gemiddelde. Het verschil is statistisch significant.
- p groter dan 0,05: er is geen verschil aangetoond. Dat is iets anders dan bewijzen dat er geen verschil is: misschien is het verschil klein, of de steekproef te klein om het te zien.
Let op: ANOVA zegt alleen dat er ergens een verschil is, niet tussen welke groepen. Daarvoor doe je na een significante uitkomst een vervolgtoets, zoals die van Tukey, die de groepen paarsgewijs vergelijkt.
Een voorbeeld
We vergelijken de lengte van volleyballers, voetballers en wielrenners. Binnen elke groep zijn er verschillen: niet alle wielrenners zijn even lang. De vraag is of er ook tussen de groepen verschillen zijn die groter zijn dan je op grond van die spreiding zou verwachten.
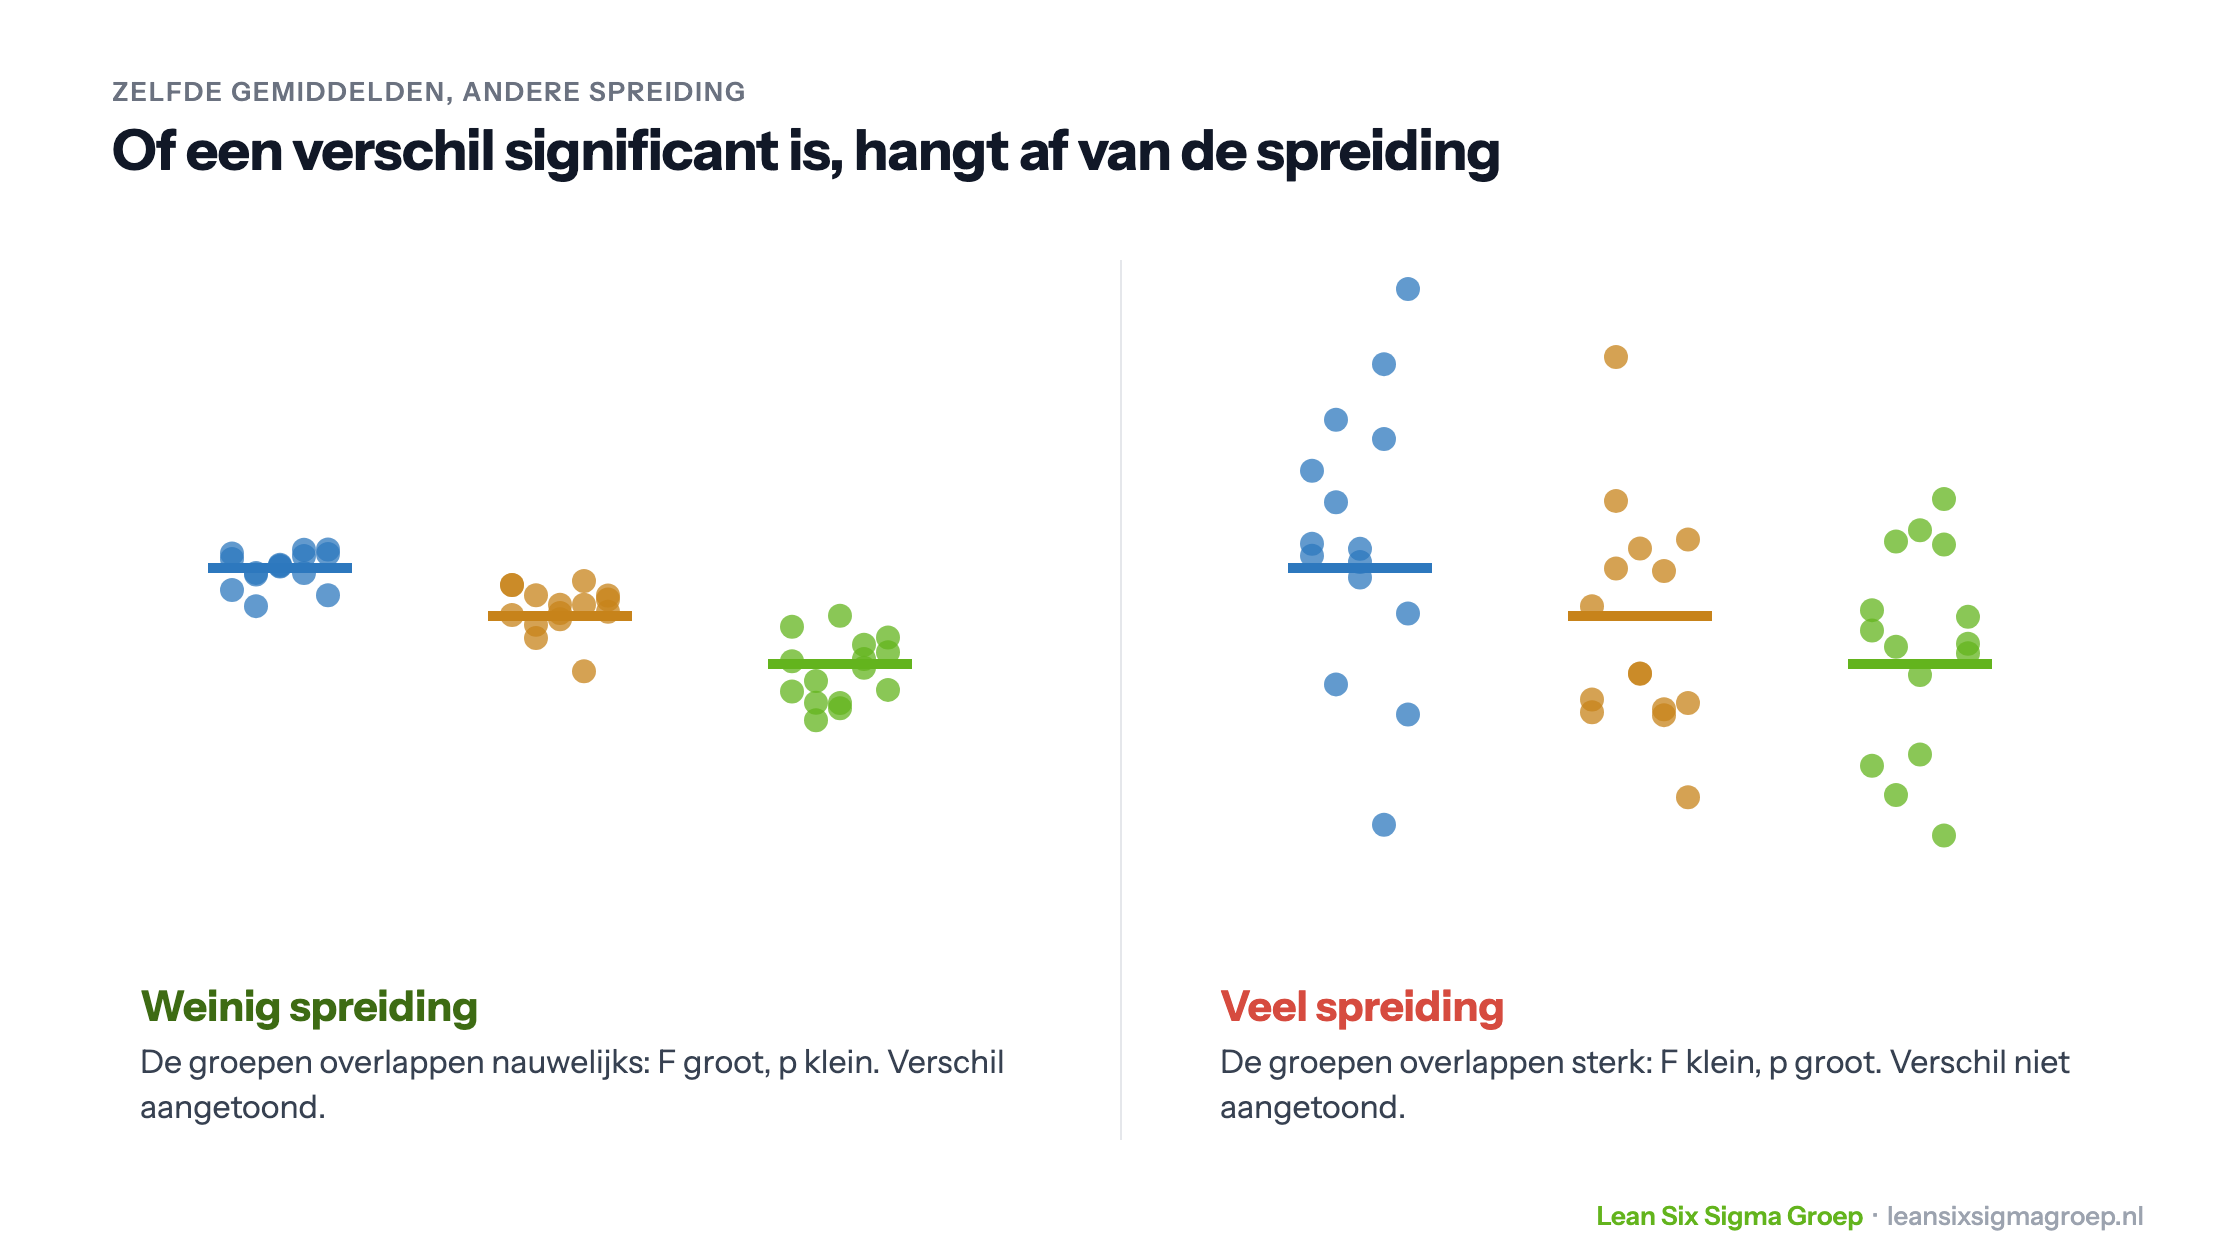
Of een verschil significant is, hangt dus niet alleen af van hoe ver de gemiddelden uit elkaar liggen, maar ook van de spreiding. Hieronder zie je twee situaties met dezelfde gemiddelden. Links is de spreiding klein en is het verschil aangetoond, rechts is de spreiding groot en niet.
Eenweg en tweeweg
In het voorbeeld is er één factor: de sport, met drie niveaus (volleybal, voetbal, wielrennen). De lengte is de uitkomst, de Y. Dat heet een eenweg-variantieanalyse (one-way ANOVA). Kijk je ook naar een tweede factor, bijvoorbeeld het geslacht, dan is het een tweeweg-variantieanalyse (two-way ANOVA). Die laat ook zien of de twee factoren elkaar beïnvloeden, de zogenaamde interactie. Dat is ook de basis van een Design of Experiments.
Voorwaarden
ANOVA gaat uit van een paar voorwaarden:
- De waarnemingen zijn onafhankelijk van elkaar.
- De data in elke groep is ongeveer normaal verdeeld. Bij grotere groepen is dat minder belangrijk.
- De spreiding is in alle groepen ongeveer even groot. Is dat niet zo, dan zijn er varianten van de toets, zoals de Welch-ANOVA.
Begin daarom altijd met een grafiek, zoals een boxplot per groep. Die laat in één oogopslag de gemiddelden, de spreiding en uitschieters zien.
ANOVA en Six Sigma
Six Sigma draait om het terugdringen van variatie. In de Analyse-fase van een project wil je weten welke factoren de uitkomst echt beïnvloeden. Verschilt de doorlooptijd per team, per dag of per soort aanvraag? Met ANOVA toets je dat, in plaats van op gevoel te concluderen. Het is een van de hypothesetoetsen die je in een Lean Six Sigma-project gebruikt.
Wie bedacht het?
De Britse statisticus en geneticus Ronald Fisher ontwikkelde de variantieanalyse in de jaren twintig van de vorige eeuw, voor landbouwproeven. De F in de toets is naar hem genoemd.
Hulpmiddelen
Met de hand is een ANOVA veel rekenwerk. Statistiekprogramma’s als Minitab en SPSS geven de uitkomst in een paar seconden, en ook Excel kan een eenvoudige ANOVA uitvoeren. In de Black Belt-opleiding leer je hoe je de toets kiest, uitvoert en de uitkomst uitlegt.