De normale verdeling, ook wel de Gausscurve of klokcurve, is een van de belangrijkste begrippen in de statistiek. Veel metingen in natuur en processen volgen deze klokvorm. Weet je dat een proces normaal verdeeld is, dan kun je met een beperkte meting al goed voorspellen hoe het presteert. Daarom speelt de normale verdeling een grote rol in Six Sigma.
Wat is de normale verdeling?
De normale verdeling is een symmetrische kansverdeling met één piek in het midden en steeds kleinere kansen naar beide kanten. Twee getallen bepalen de hele verdeling:
- Het gemiddelde (μ, mu): het midden van de curve, de typische waarde.
- De standaarddeviatie (σ, sigma): de breedte van de curve, oftewel hoe ver de metingen gemiddeld rond het gemiddelde liggen. Strikt genomen is het de wortel uit de gemiddelde gekwadrateerde afstand tot het gemiddelde.
De 68-95-99,7-regel
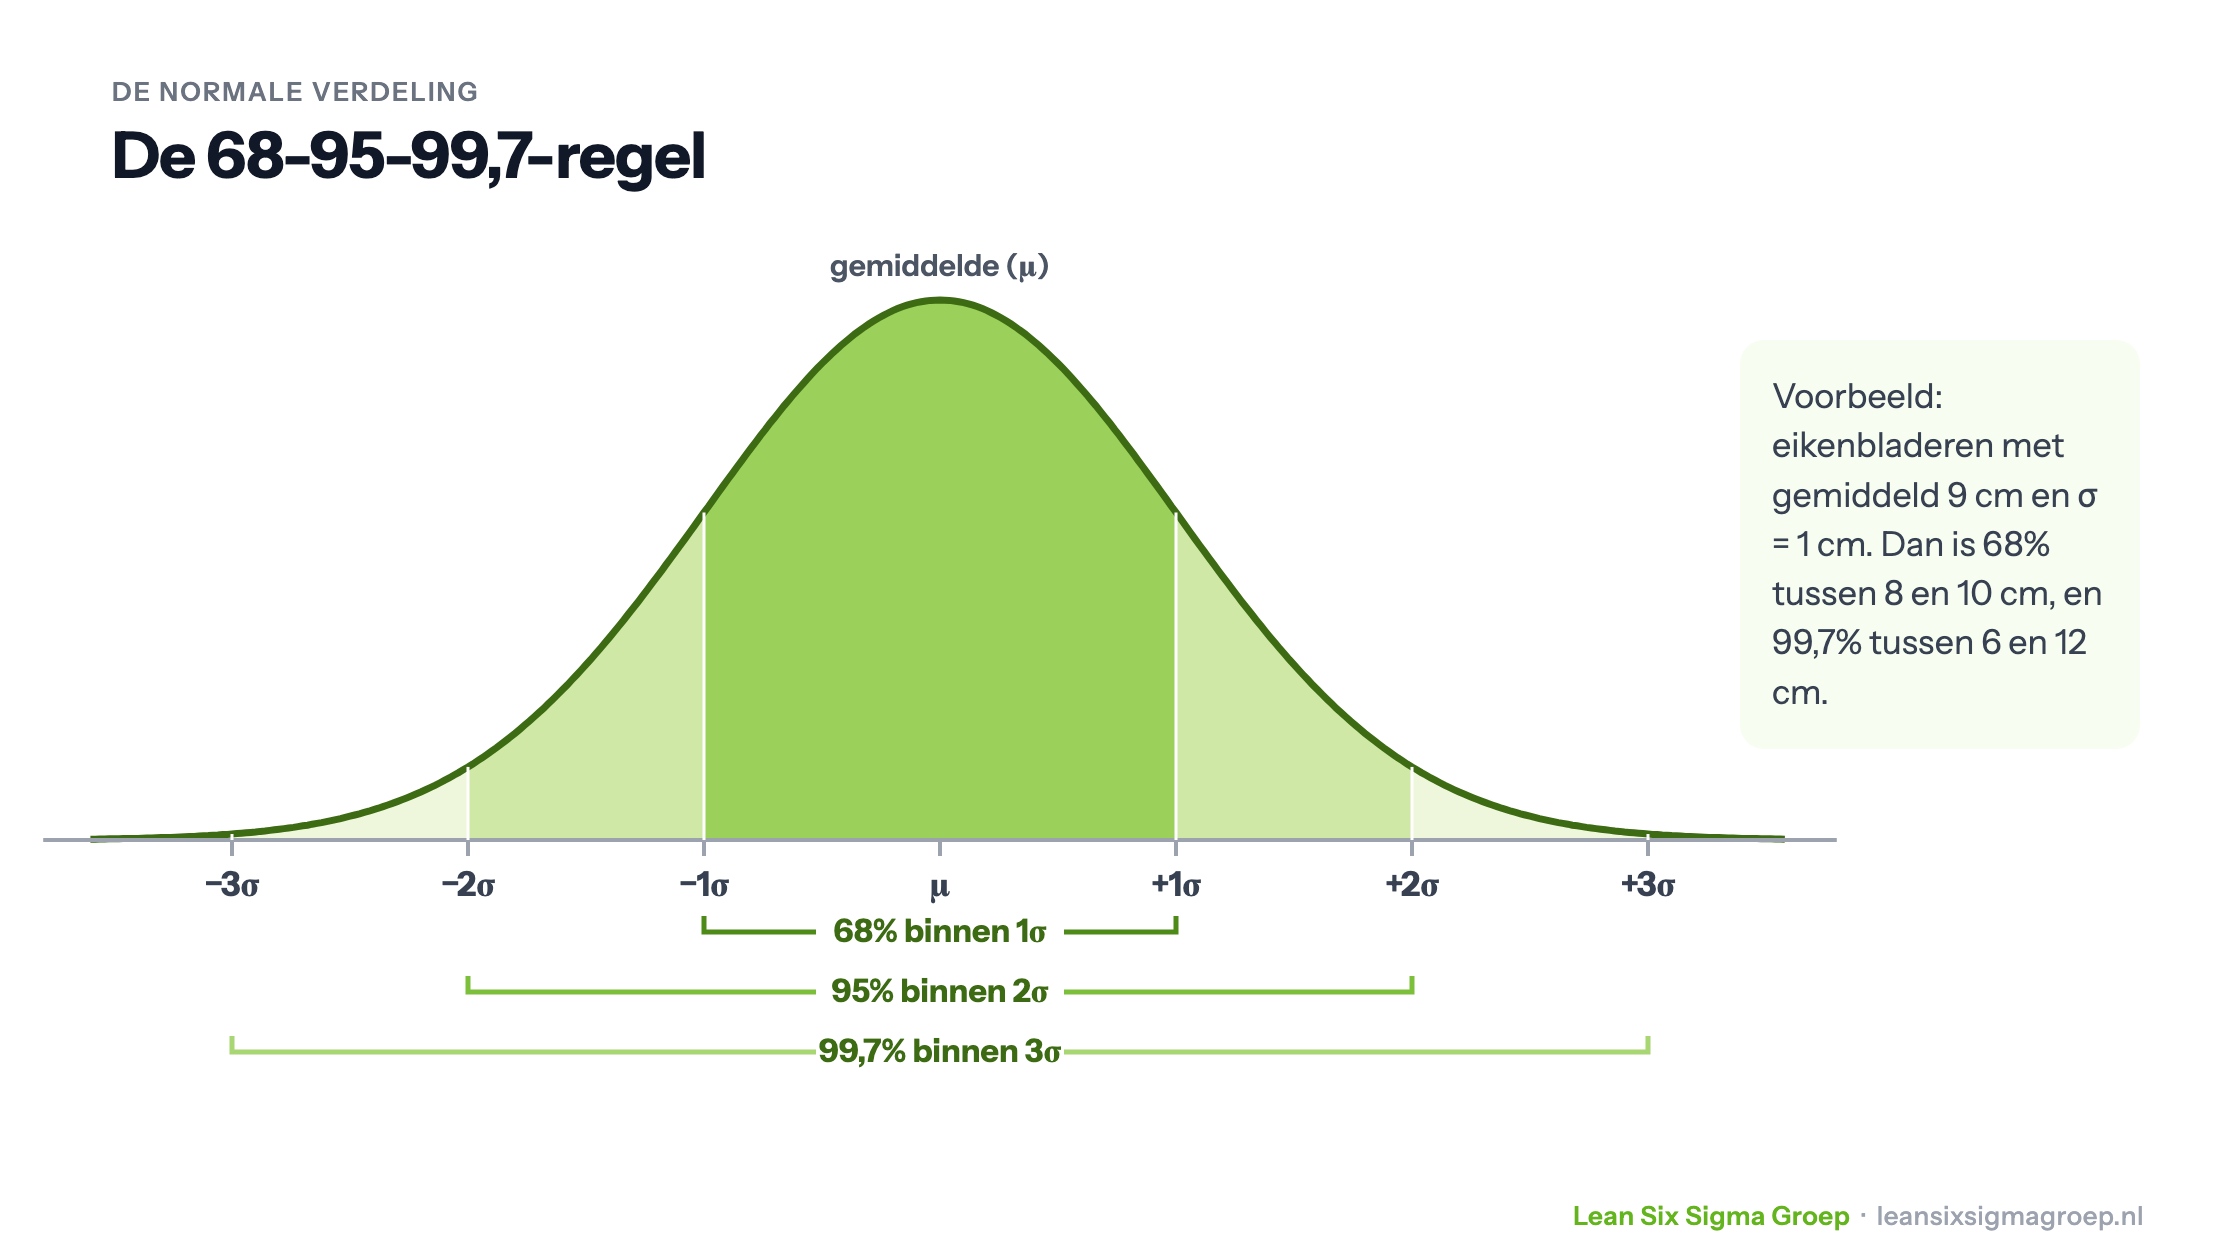
Een belangrijke eigenschap is de empirische regel, die je in de afbeelding bovenaan dit artikel ziet:
- ongeveer 68% van de metingen ligt binnen één standaarddeviatie van het gemiddelde;
- ongeveer 95% binnen twee standaarddeviaties;
- ongeveer 99,7% binnen drie standaarddeviaties.
Een voorbeeld: meet je de bladeren van een eik, met een gemiddelde lengte van 9 cm en een standaarddeviatie van 1 cm, dan is 68% van de bladeren tussen 8 en 10 cm lang, en 99,7% tussen 6 en 12 cm. Een blad van 13 cm is dan zo uitzonderlijk dat het de moeite waard is om te onderzoeken.
Hoe ontstaat een normale verdeling?
Een normale verdeling ontstaat vaak als een meting het gevolg is van veel kleine, onafhankelijke, toevallige invloeden. Daarom komt hij veel voor in de natuur, bij lengtes, gewichten en meetfouten.
Niet alles is normaal verdeeld. Doorlooptijden zijn bijvoorbeeld vaak scheef verdeeld: ze kunnen niet onder nul, maar wel heel lang uitlopen. Ook een bijzondere oorzaak, zoals een machine die ontregeld raakt, verstoort de normale verdeling. Controleer daarom altijd eerst of je gegevens normaal verdeeld zijn, bijvoorbeeld met een histogram of een normaliteitstoets, voordat je ermee gaat rekenen.
De centrale limietstelling verklaart waarom de normale verdeling toch zo vaak bruikbaar is: neem je herhaaldelijk een steekproef en bereken je telkens het gemiddelde, dan zijn die gemiddelden bij benadering normaal verdeeld, ook als de metingen zelf dat niet zijn. Dat geldt voor gemiddelden, niet voor de losse metingen.
De normale verdeling in Six Sigma
Six Sigma wil de kwaliteit van processen verbeteren door spreiding te verminderen. De normale verdeling helpt om te beschrijven hoe een proces zich gedraagt. Blijkt uit de gegevens dat een proces normaal verdeeld is, en daarvoor volstaan vaak al zo’n 30 metingen, dan kun je er verder mee rekenen.
Z-score en sigmaniveau
De Z-score koppelt de klantwens aan het proces. Hij geeft aan hoeveel standaarddeviaties er passen tussen het gemiddelde van het proces en de grens die de klant stelt. Uit de Z-score volgt de kans op een defect: het deel van de curve dat buiten de grens valt.
De Z-score heet ook wel het sigmaniveau, en daar komt de naam Six Sigma vandaan. Een proces op Six Sigma-niveau levert, met de gebruikelijke correctie van 1,5 sigma voor verschuiving op de lange termijn, 3,4 defecten per miljoen kansen op.
Defecten per miljoen kansen (DPMO)
DPMO is het aantal defecten per miljoen kansen op een fout. Je telt het gewoon, maar met de normale verdeling kun je het ook vooraf berekenen uit het gemiddelde en de standaarddeviatie, en omzetten naar een sigmaniveau. Zo maak je de prestatie van verschillende processen vergelijkbaar. Lees ook over Cp en Cpk, die op dezelfde manier procesgeschiktheid uitdrukken.
Regelkaarten
Een regelkaart laat de uitkomsten van een proces in de tijd zien, met het gemiddelde en een boven- en ondergrens op drie standaarddeviaties: de Upper Control Limit (UCL) en de Lower Control Limit (LCL). Binnen die grenzen valt bij een stabiel proces 99,7% van de punten.
Punten binnen de grenzen horen bij de gewone spreiding van het proces, de common cause variation. Een punt buiten de grenzen, of een opvallend patroon zoals zeven punten op rij aan één kant van het gemiddelde, wijst op een bijzondere oorzaak, de special cause variation. Die onderzoek je. Hoe kleiner de standaarddeviatie, hoe dichter de grenzen bij elkaar liggen.
DMAIC
In de Measure- en Analyse-fase van DMAIC gebruik je de normale verdeling om gegevens te beschrijven, de procesprestatie te bepalen en verschillen te toetsen.
Praktijkvoorbeeld: flessen vullen
Een machine vult flessen van 500 ml. Een fles mag niet minder dan 490 ml bevatten. Het team meet dat de vulling gemiddeld 500 ml is, met een standaarddeviatie van 5 ml.
In de Black Belt training ga je hier statistisch dieper op in.
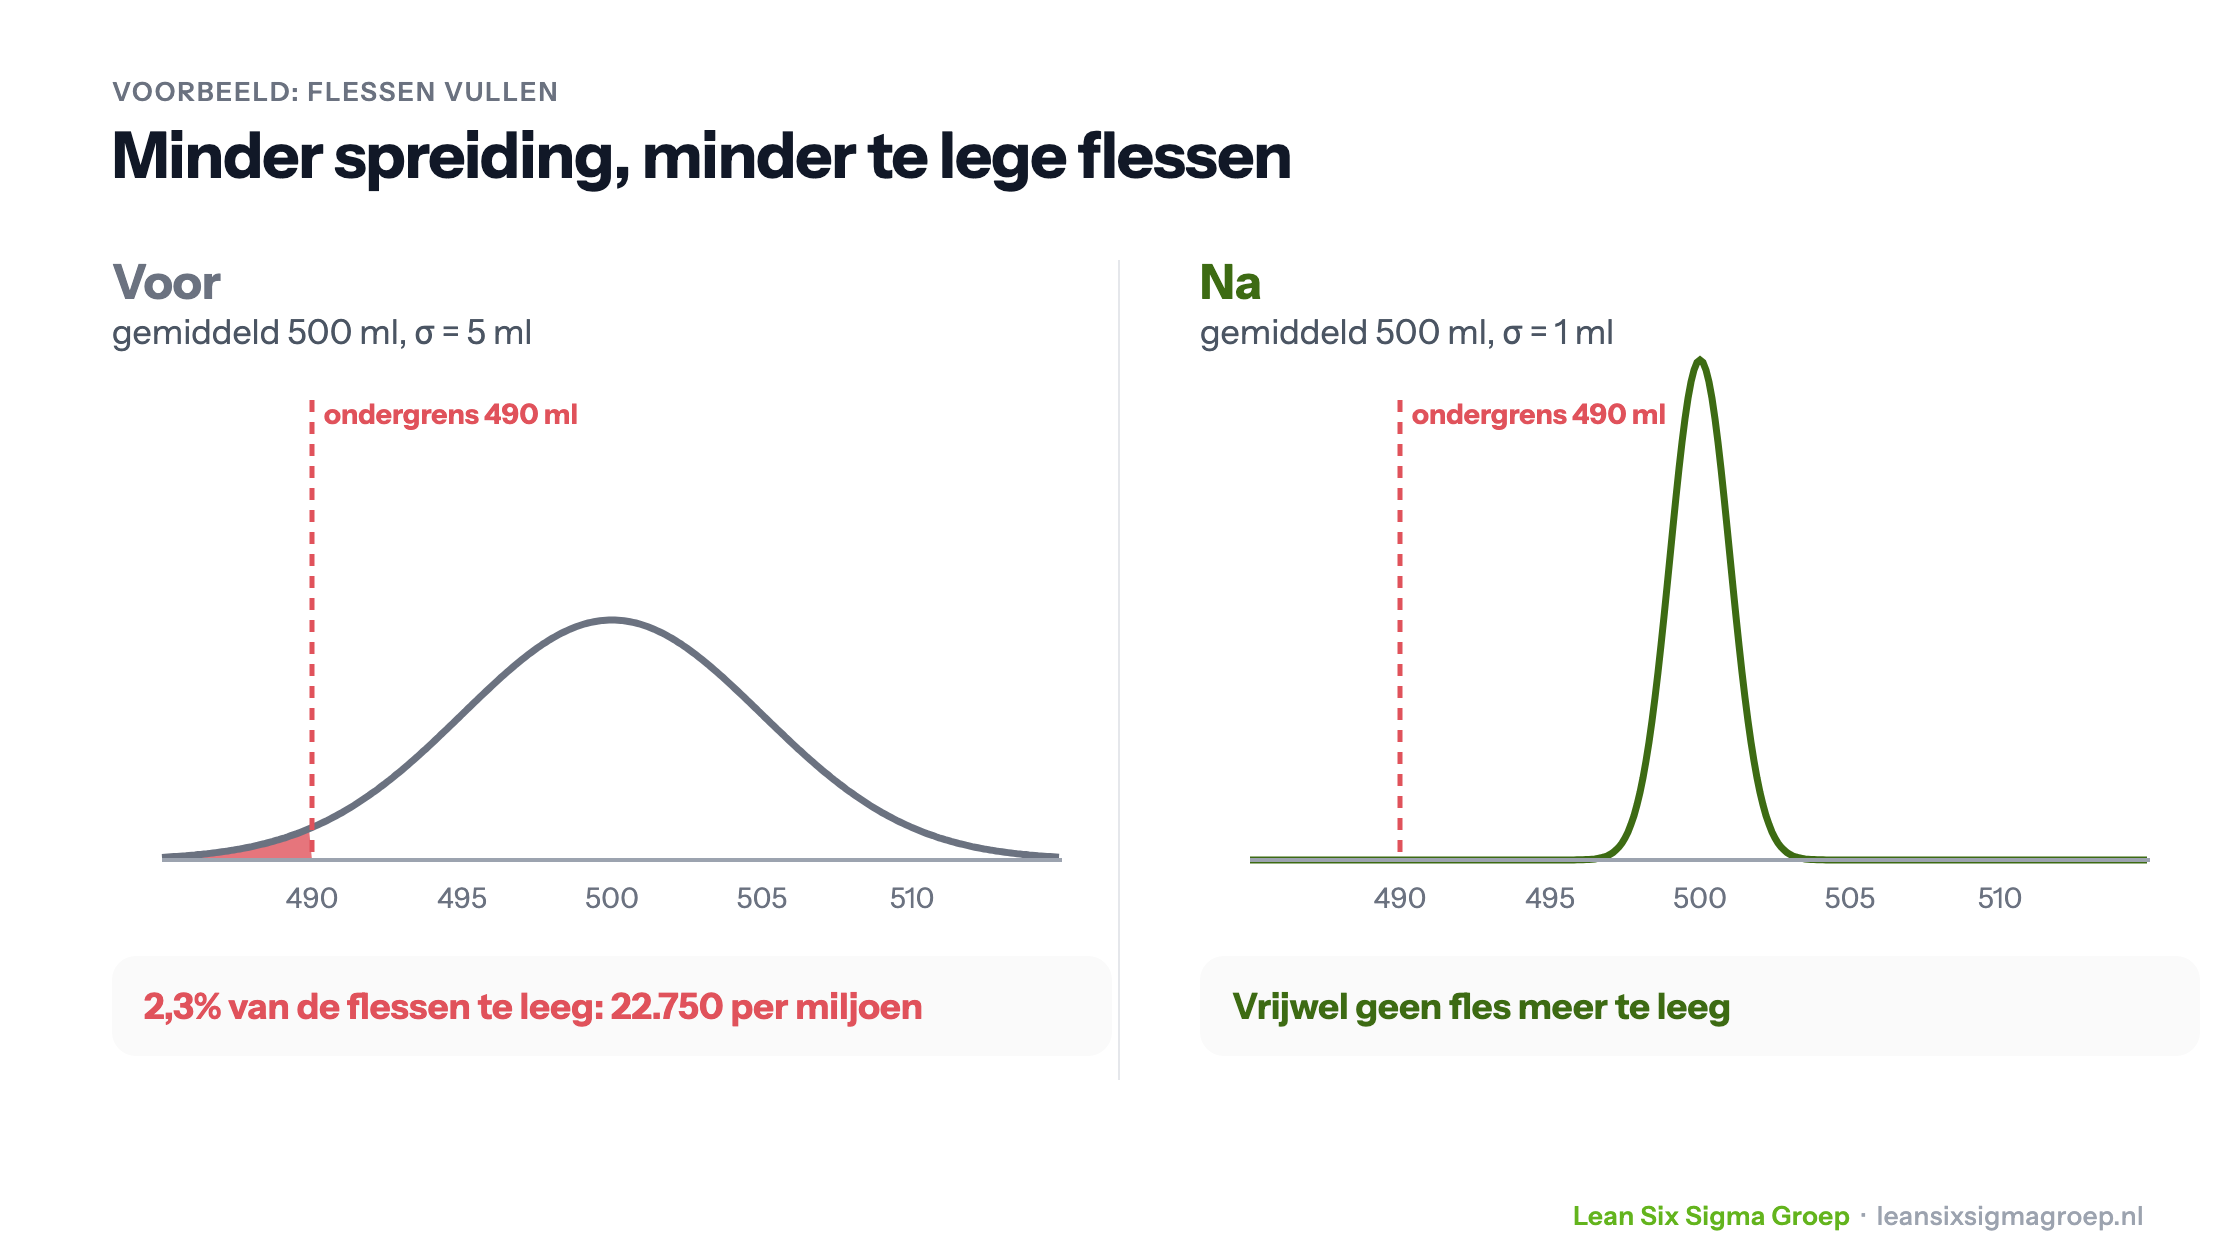
De ondergrens ligt dan twee standaarddeviaties onder het gemiddelde (Z = 2). Volgens de normale verdeling valt 2,3% van de flessen daaronder: 22.750 per miljoen. Met DMAIC vindt het team de oorzaken van de spreiding, kalibreert de vulmachine en traint de operators. De standaarddeviatie zakt naar 1 ml. De ondergrens ligt nu tien standaarddeviaties van het gemiddelde, en vrijwel geen fles is nog te leeg. Het gemiddelde is niet veranderd: alleen de spreiding is kleiner geworden.
Conclusie
De normale verdeling helpt je spreiding te begrijpen en op basis van gegevens te beslissen hoe je een proces verbetert. Minder spreiding betekent minder defecten, efficiëntere processen en tevredener klanten.
In de video bij dit artikel zie je een korte uitleg van de normale verdeling en haar eigenschappen.
Wil je zelf leren werken met de normale verdeling, statistische analyses en regelkaarten? Dat komt uitgebreid aan bod in de Green Belt-training.
Van theorie naar praktijk
Dit leer je toepassen in de praktijk
Onderwerpen als De Normale Verdeling pas je in de Black Belt training toe op complexe verbeterprojecten, met statistische onderbouwing.
Eerstvolgende startdata
Lean Six Sigma Black Belt training →Nog niet klaar voor een training?Gratis White Belt workshop