Datamining is het zoeken naar patronen in grote hoeveelheden gegevens: verbanden, groepen en trends die je niet vooraf bedacht had. Die patronen gebruik je om te begrijpen wat er gebeurt, en om te voorspellen wat er gaat gebeuren. Waar data-analyse in een verbeterproject vooral een vermoeden toetst, gaat datamining op zoek naar wat je nog niet wist.
Waar komt het vandaan?
Statistiek bestaat al eeuwen, en in de jaren twintig van de vorige eeuw gebruikte Walter Shewhart haar al om processen te bewaken, met wat later statistische procesbeheersing (SPC) ging heten. Datamining is jonger. Het begrip kwam op in de jaren negentig, toen bedrijven steeds meer gegevens in databases opsloegen en computers krachtig genoeg werden om daarin te zoeken. Datamining combineert statistiek, databasetechniek en machine learning.
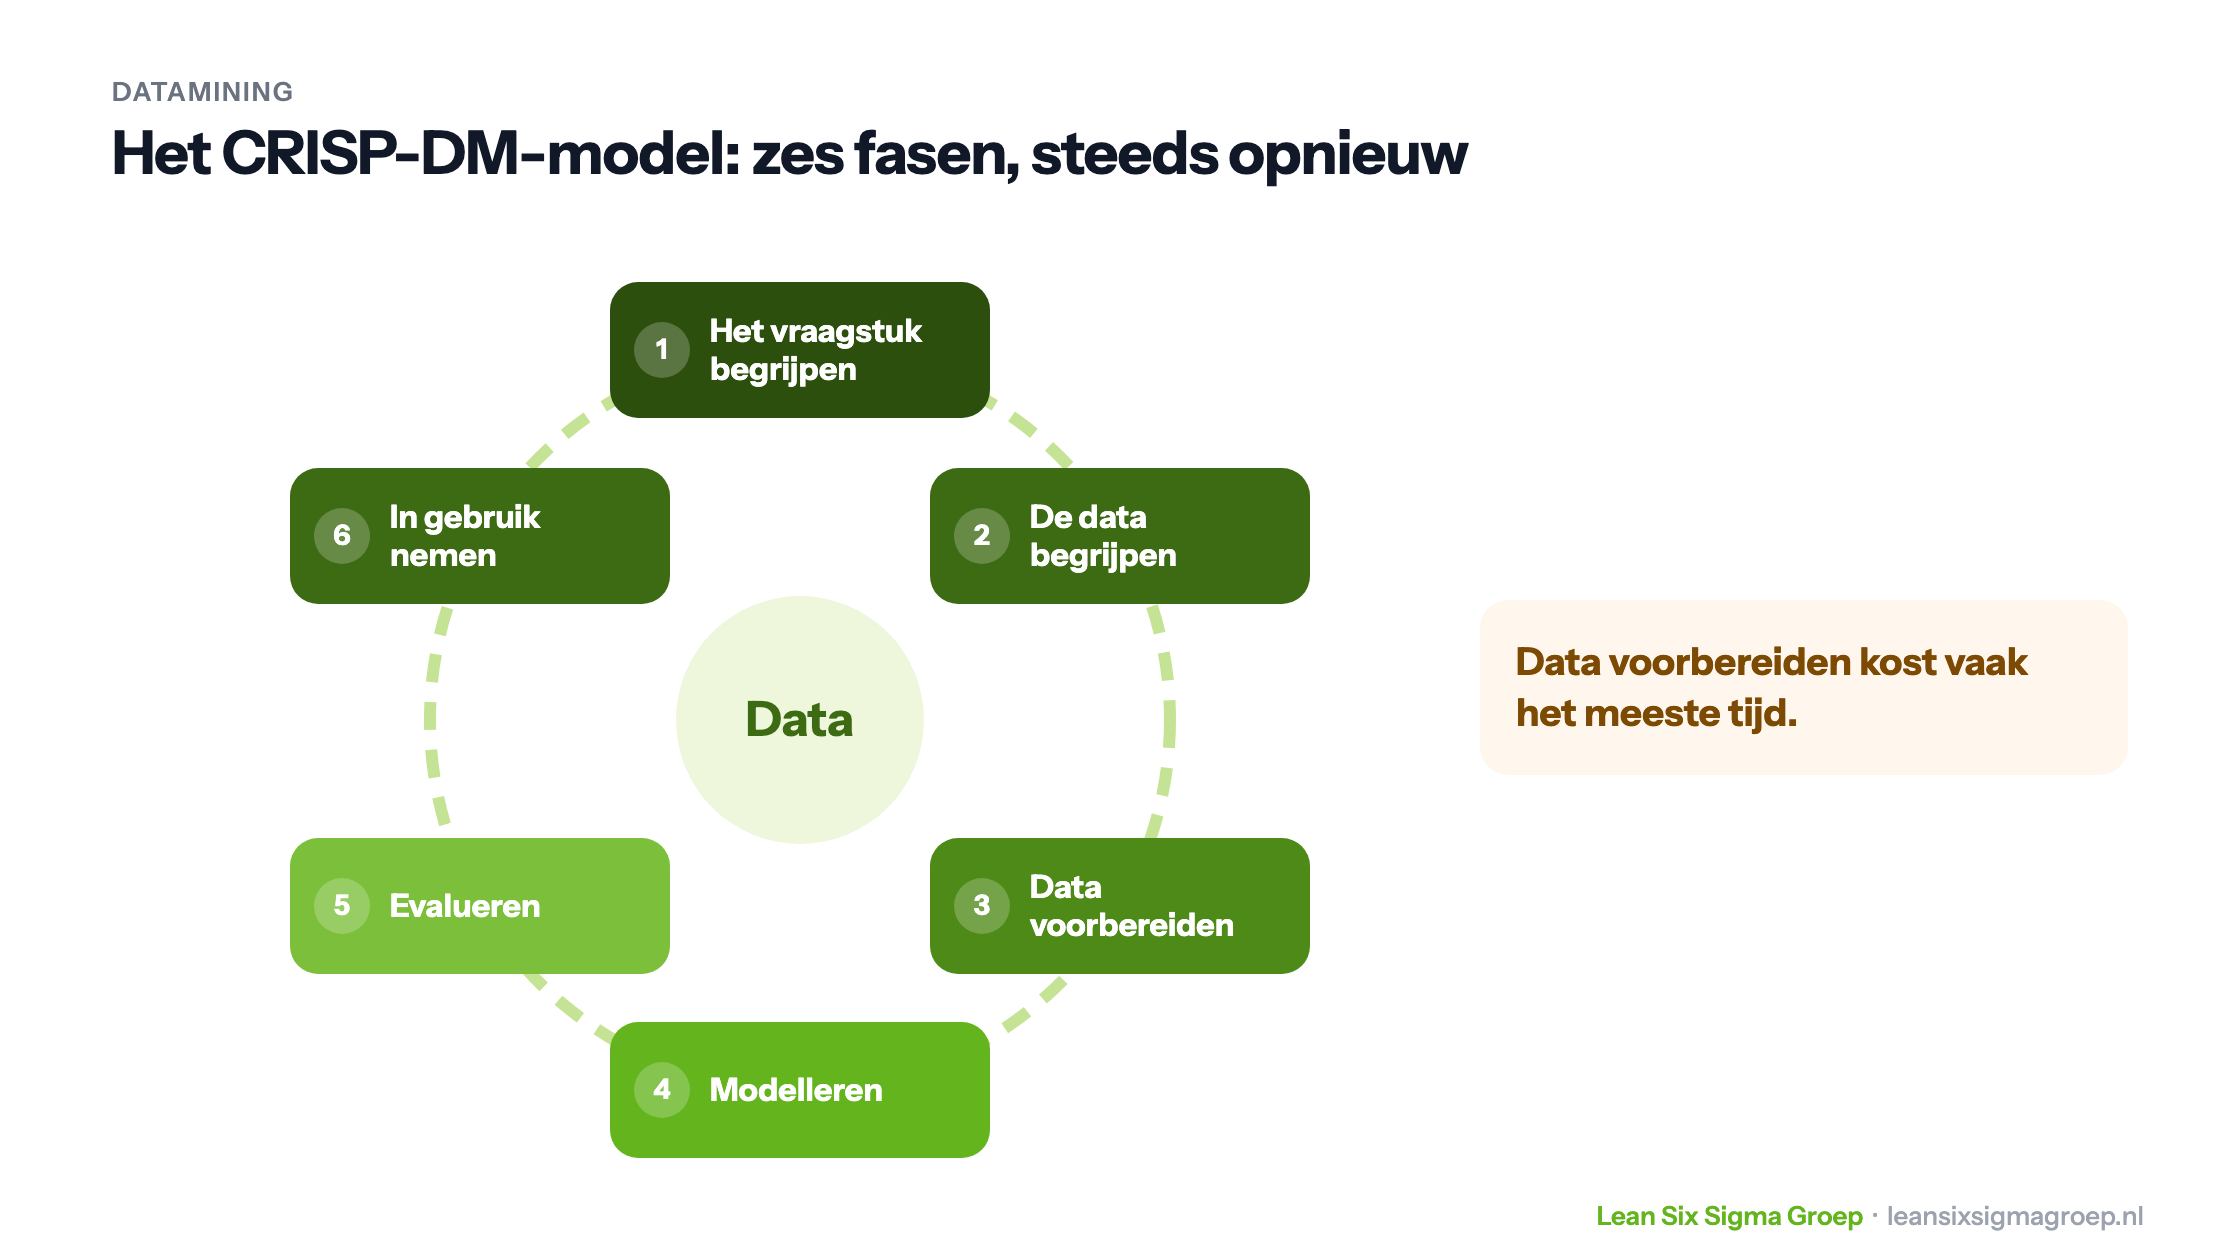
Rond 1999 stelde een groep bedrijven het CRISP-DM-model op, een stappenplan dat nog altijd veel gebruikt wordt. Je ziet het in de afbeelding bovenaan dit artikel:
- Het vraagstuk begrijpen. Welke vraag wil de organisatie beantwoord zien?
- De data begrijpen. Welke gegevens zijn er, en hoe betrouwbaar zijn ze?
- Data voorbereiden. Opschonen, samenvoegen, ontbrekende waarden aanpakken. Dit kost vaak de meeste tijd.
- Modelleren. Technieken toepassen die patronen zoeken.
- Evalueren. Klopt het model, en beantwoordt het de vraag?
- In gebruik nemen. Het model inzetten in het werk, en blijven volgen.
Het is geen rechte lijn: na elke fase kan blijken dat je terug moet.
Wat voor patronen zoek je?
Datamining zoekt grofweg naar vier soorten patronen, zoals je hieronder ziet.
Dit is een van de tools die je in de Green Belt training leert toepassen op een eigen verbeterproject.
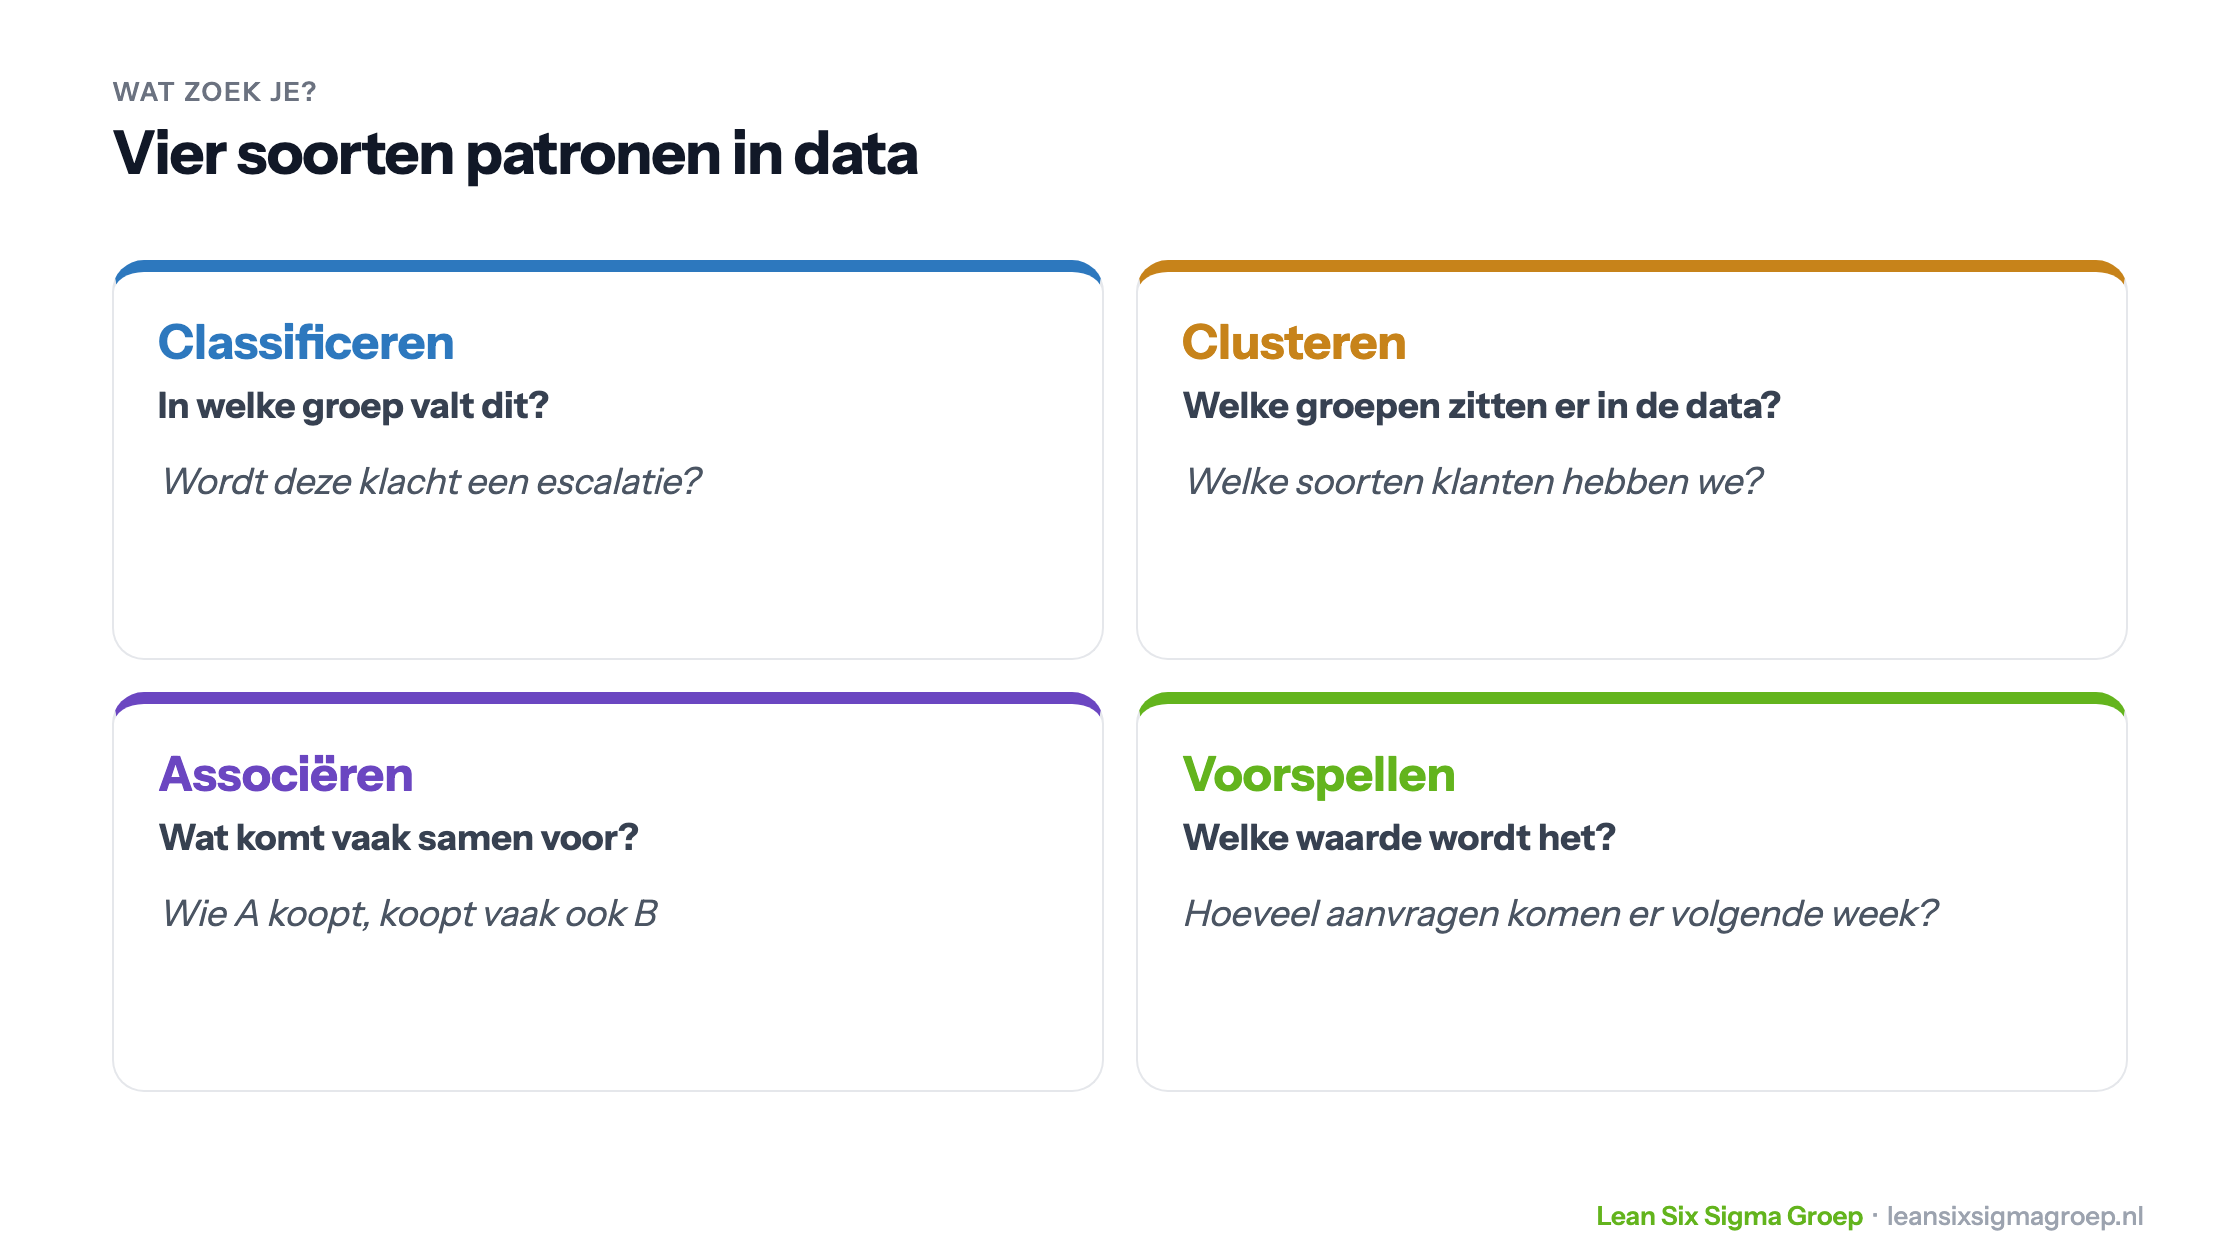
- Classificeren: in welke groep valt iets? Bijvoorbeeld: wordt deze klacht een escalatie, is deze transactie verdacht?
- Clusteren: welke groepen zitten er in de data, zonder dat je ze vooraf bedenkt? Bijvoorbeeld soorten klanten met een vergelijkbaar gedrag.
- Associëren: wat komt vaak samen voor? Het bekendste voorbeeld is de winkelmand: wie A koopt, koopt vaak ook B.
- Voorspellen: welke waarde wordt het? Hoeveel aanvragen komen er volgende week, hoe lang gaat deze levering duren?
Voorspellen met het verleden
Het idee achter datamining is dat patronen uit het verleden iets zeggen over de toekomst. Dat werkt alleen als de data goed genoeg zijn, en dat gaat over meer dan hoeveelheid.
Neem een peiling voor een verkiezing. Een grote steekproef helpt, maar als je alleen mensen van boven de zestig vraagt, voorspel je de uitslag toch verkeerd. De steekproef moet representatief zijn: kenmerken die het stemgedrag beïnvloeden, zoals leeftijd, inkomen of woonplaats, moeten in de juiste verhouding vertegenwoordigd zijn. In Six Sigma heten zulke invloedsfactoren de X’en. Hetzelfde geldt voor elke dataset: zitten de situaties waarover je iets wilt voorspellen er wel in?
Valkuilen
- Een verband is geen oorzaak. Datamining vindt samenhang, geen verklaring. Lees daarover bij correlatie.
- Toevalstreffers. Wie lang genoeg zoekt, vindt altijd een patroon. Toets een model daarom op gegevens die niet gebruikt zijn om het te maken.
- Het verleden is niet de toekomst. Verandert de situatie, dan klopt het patroon niet meer. Mensen zijn veranderlijker dan het weer.
- Privacy. Gaat het om persoonsgegevens, dan gelden de regels van de AVG.
Datamining en procesverbetering
In procesverbetering gaan datamining en de aanpak van Six Sigma goed samen. Datamining wijst waar je moet kijken; met DMAIC en een gerichte toets stel je vast of een oorzaak echt is, en verbeter je het proces. Een bijzondere vorm is process mining, dat uit de gegevens van IT-systemen afleidt hoe een proces in werkelijkheid loopt.