De standaarddeviatie is een maat voor spreiding: hoe ver liggen de waarden in een dataset gemiddeld van het gemiddelde af? Een gemiddelde alleen zegt weinig. Pas met de standaarddeviatie erbij weet je of alle waarden dicht bij elkaar liggen, of juist ver uiteen.
Wat is de standaarddeviatie?
De standaarddeviatie, ook wel standaardafwijking, geef je aan met de Griekse letter σ (sigma) als het om een hele populatie gaat, en met s als het om een steekproef gaat.
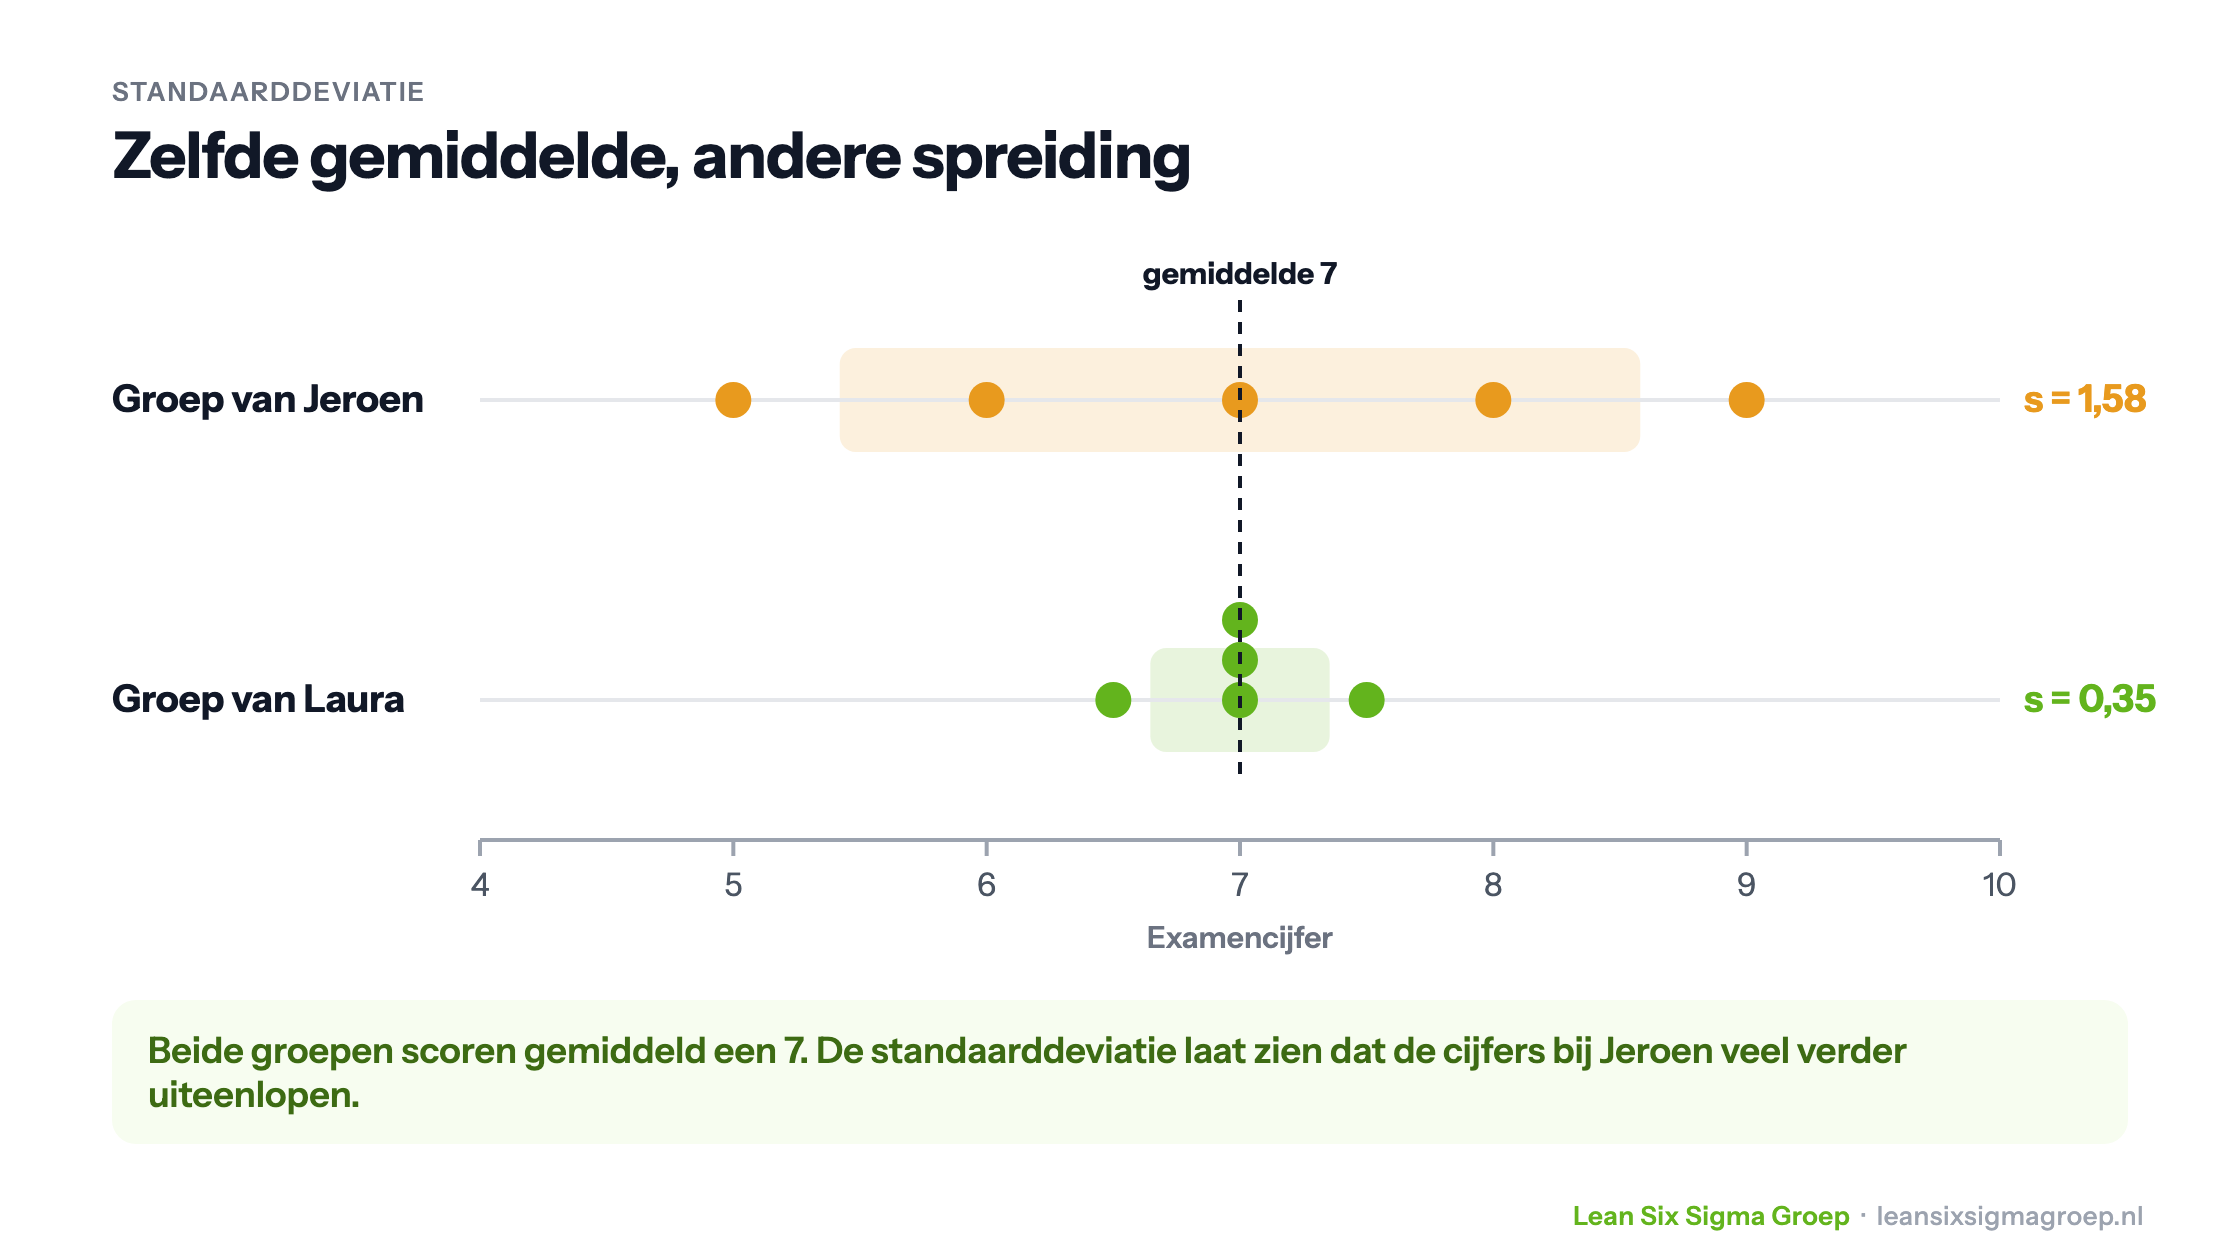
In de afbeelding bovenaan dit artikel zie je waarom je hem nodig hebt. Twee trainers, Jeroen en Laura, vergelijken de examencijfers van hun Green Belt-groepen. Beide groepen halen gemiddeld een 7. Maar bij Jeroen lopen de cijfers uiteen van 5 tot 9, bij Laura liggen ze tussen 6,5 en 7,5. De standaarddeviatie van Jeroens groep is 1,58, die van Laura’s groep 0,35. Dat inzicht helpt Jeroen om gerichter aanvullende uitleg te geven.
Zo bereken je de standaarddeviatie
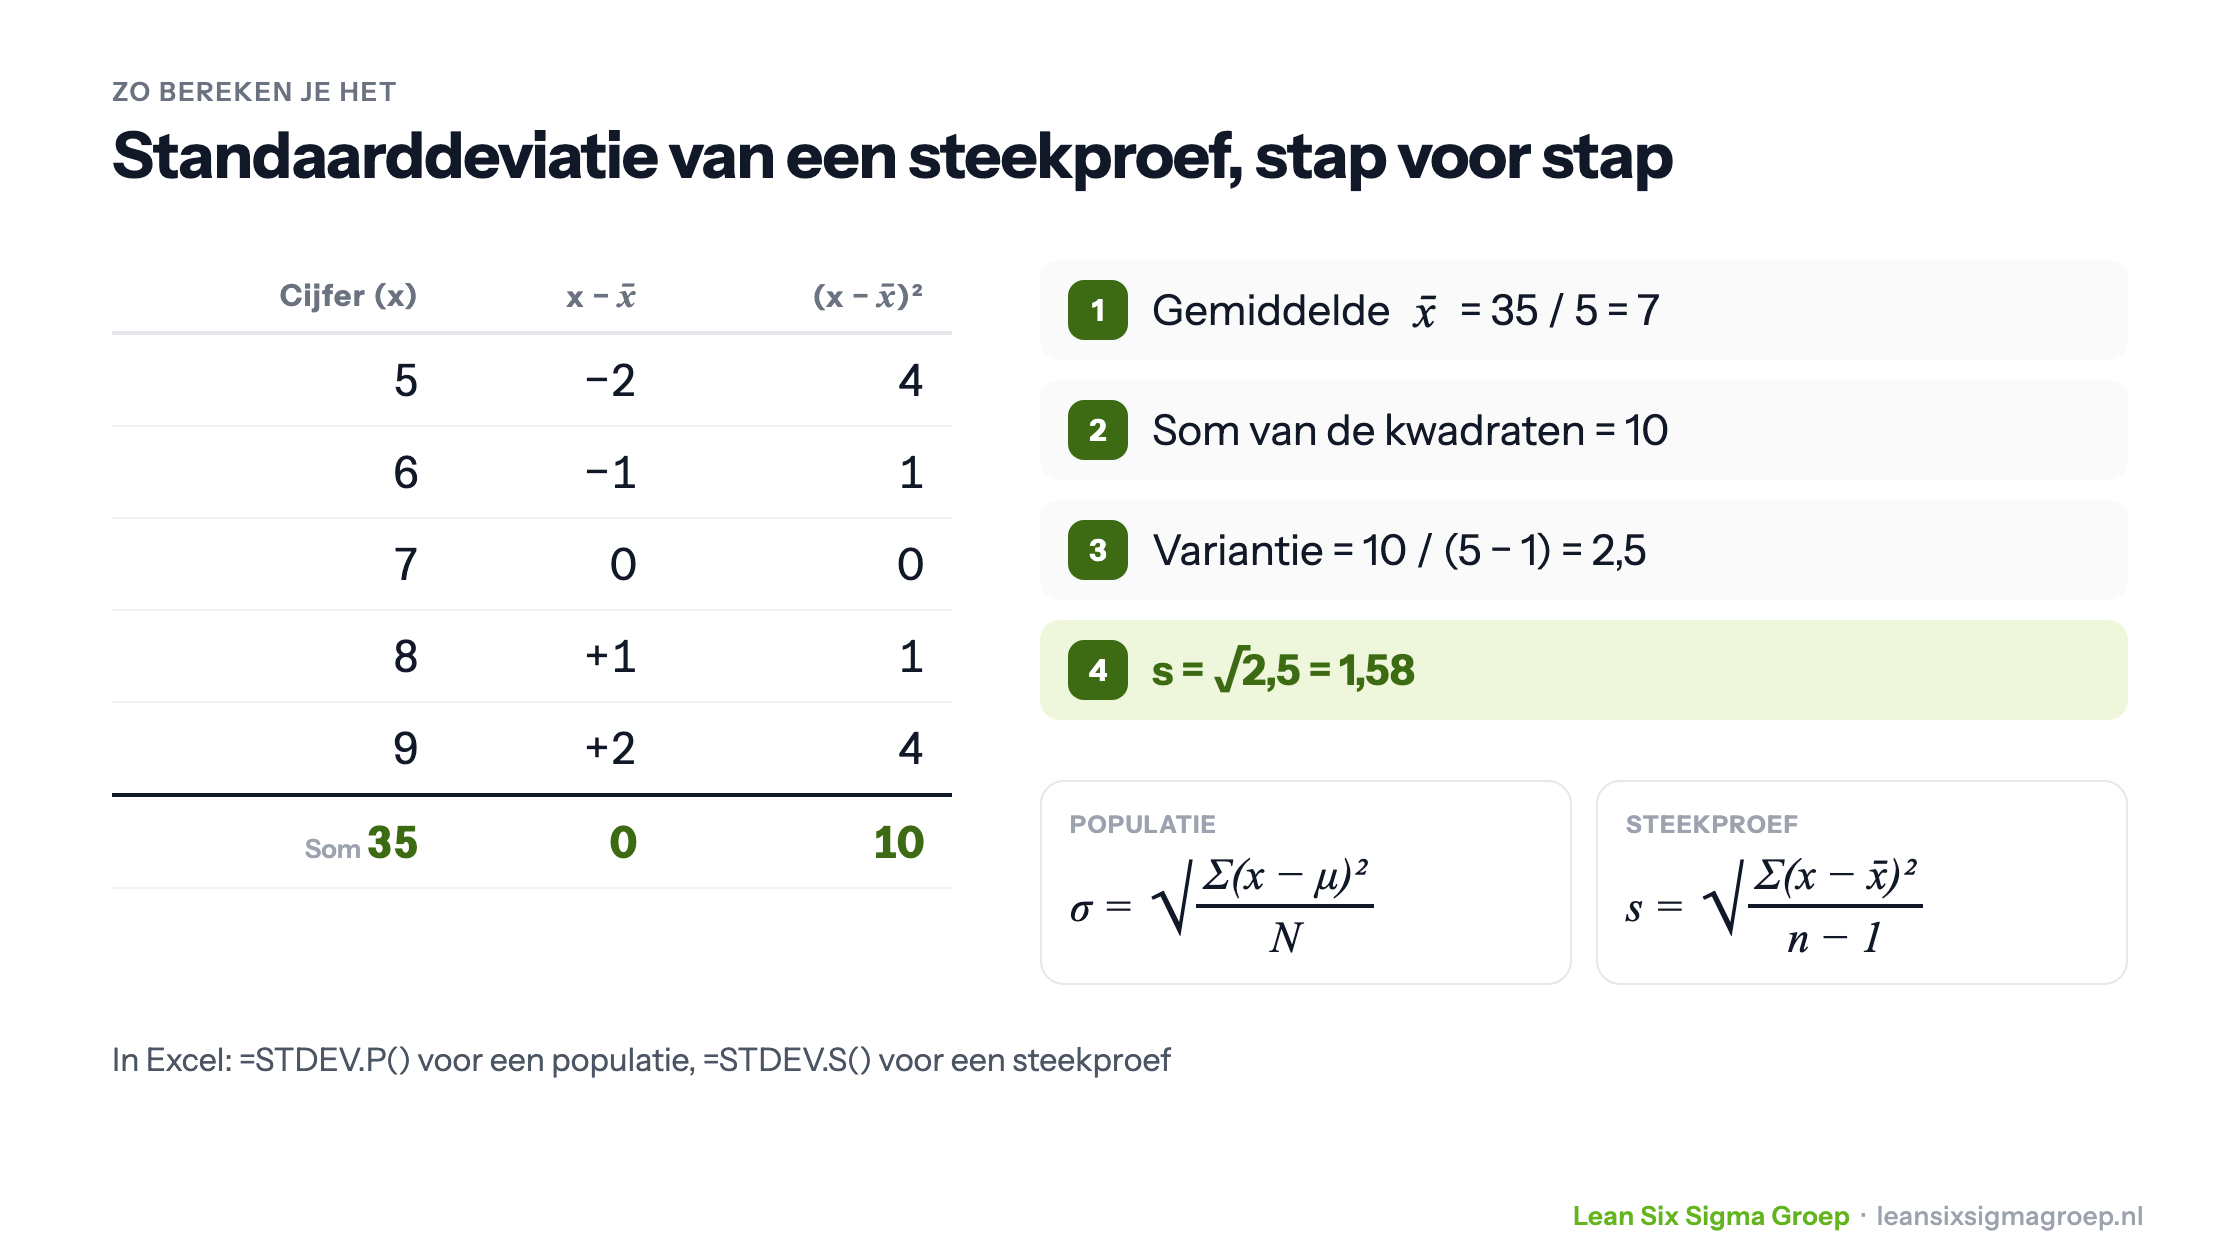
- Bereken het gemiddelde: tel alle waarden op en deel door het aantal.
- Bereken de afwijkingen: trek het gemiddelde af van elke waarde.
- Kwadrateer de afwijkingen: vermenigvuldig elke afwijking met zichzelf, zodat negatieve afwijkingen niet wegvallen tegen positieve.
- Bereken de variantie: tel de kwadraten op en deel door het aantal waarden (N) bij een populatie, of door het aantal min één (n − 1) bij een steekproef.
- Trek de wortel: de wortel uit de variantie is de standaarddeviatie, weer in dezelfde eenheid als je gegevens.
Hieronder zie je de berekening voor de groep van Jeroen, met de formules voor een populatie en een steekproef.
In de Black Belt training ga je hier statistisch dieper op in.
Waarom delen door n − 1 bij een steekproef? Een steekproef laat gemiddeld iets minder spreiding zien dan de hele populatie, omdat je de afwijkingen meet ten opzichte van het gemiddelde van diezelfde steekproef. Delen door n − 1 corrigeert daarvoor.
In Excel gebruik je =STDEV.P() voor een populatie en =STDEV.S() voor een steekproef. Gaat het om alle gegevens die er zijn, dan is het een populatie; heb je een deel gemeten, dan is het een steekproef.
Waarom is de standaarddeviatie belangrijk?
Een lage standaarddeviatie betekent dat de waarden dicht bij het gemiddelde liggen, een hoge dat ze ver uiteenlopen. Dat is in veel situaties belangrijk:
- Onderwijs: zijn de resultaten van leerlingen vergelijkbaar, of lopen ze sterk uiteen?
- Bedrijfsleven: hoe sterk schommelen de verkoopcijfers, en hoe goed kan een proces binnen de specificaties van de klant blijven?
- Zorg: hoe verschillend reageren patiënten op een behandeling?
Standaarddeviatie en Six Sigma
Six Sigma wil processen verbeteren door defecten en spreiding te verminderen. De naam zegt het al: sigma is de standaarddeviatie. Bij een Six Sigma-proces liggen de grenzen van de klant zes standaarddeviaties van het procesgemiddelde. Omdat een proces op de lange termijn wat verschuift, rekent men met een marge van 1,5 sigma. Wat overblijft, 4,5 sigma, komt overeen met 3,4 defecten per miljoen kansen.
Hoe kleiner de standaarddeviatie, hoe meer standaarddeviaties er tussen het gemiddelde en de grens passen, en hoe minder defecten. Daarom draait verbeteren in Six Sigma zo vaak om het verkleinen van de spreiding. Lees ook over Cp en Cpk, die precies dit uitdrukken.
Normaal en niet-normaal verdeelde gegevens
Bij een normale verdeling, de symmetrische klokcurve, ligt ongeveer 68% van de waarden binnen één standaarddeviatie van het gemiddelde, 95% binnen twee en 99,7% binnen drie. Dat maakt voorspellen eenvoudig.
Niet alle gegevens zijn normaal verdeeld. Bij scheve verdelingen, zoals doorlooptijden, of bij gegevens met twee pieken, kan de standaarddeviatie een misleidend beeld geven, omdat uitschieters er veel invloed op hebben. Dan geeft bijvoorbeeld de interkwartielafstand, de spreiding van de middelste helft van de waarden, een beter beeld.
Let op
- Uitschieters: één extreem hoge of lage waarde kan de standaarddeviatie flink vergroten. Controleer daarom altijd op uitschieters, en bepaal of ze terecht in de gegevens horen.
- Eerst kijken, dan rekenen: maak een histogram of een grafiek in de tijd voordat je met de standaarddeviatie gaat rekenen. Zo zie je of de gegevens normaal verdeeld en stabiel zijn.
Conclusie
De standaarddeviatie laat zien hoe groot de spreiding in je gegevens is. Of je nu student, onderzoeker of procesverbeteraar bent: wie de standaarddeviatie begrijpt, kan gegevens beter lezen en betere beslissingen nemen. Werken met spreiding en procesgeschiktheid komt uitgebreid aan bod in de Green Belt-training.